




 Spotify
 iTunes
 Amazon
 Microsmeta Podcast
 Feed Atom 0.3
 Visiteurs Français
 English Visitors
 Visite guidate a Roma
 Think different!




\\ Home Page : Storico (inverti l'ordine)
Di seguito tutti gli interventi pubblicati sul sito, in ordine cronologico.
Di Alex (del 15/06/2026 @ 15:00:00, in Storia Impero Romano, letto 444 volte)
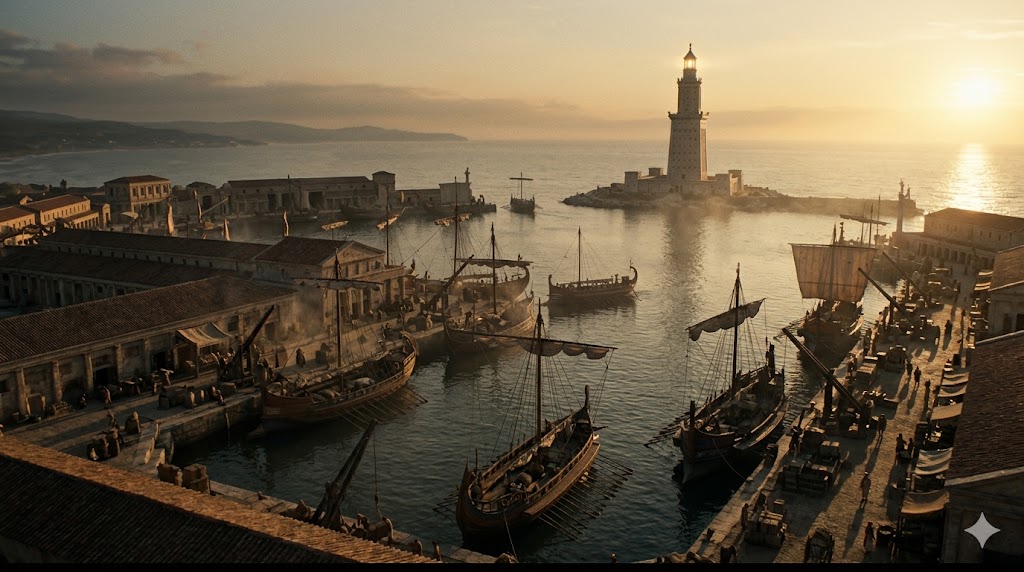
Il porto di Portus con navi mercantili e il faro monumentale
Bonus Video
L'architettura monumentale del porto di Claudio e Traiano
La costruzione di Portus iniziò sotto l'imperatore Claudio intorno all'anno 42 dopo Cristo, quando divenne evidente che il vecchio porto di Ostia, situato alla foce del Tevere, non era più in grado di gestire il traffico crescente di merci dirette a Roma. Claudio ordinò la costruzione di un bacino artificiale di straordinarie dimensioni, protetto da due imponenti moli curvilinei e da un faro monumentale ispirato al celebre faro di Alessandria. I lavori proseguirono per oltre un decennio, impiegando migliaia di schiavi, ingegneri e architetti provenienti da tutto il Mediterraneo. Il bacino claudiano copriva una superficie di circa 200 ettari, con una profondità media di sei metri, sufficiente per ospitare le più grandi navi granarie dell'epoca, che potevano trasportare fino a mille tonnellate di grano egiziano. L'imperatore Traiano, all'inizio del secondo secolo dopo Cristo, ampliò ulteriormente il complesso con un bacino esagonale di 32 ettari, collegato direttamente al Tevere tramite un canale navigabile. La forma esagonale non era una scelta estetica, ma una geniale soluzione ingegneristica: le sei pareti permettevano di distribuire uniformemente la pressione dell'acqua e di ridurre l'accumulo di sedimenti, facilitando le operazioni di carico e scarico. Le banchine erano lastricate in travertino e punteggiate da centinaia di anelli di ormeggio in bronzo, molti dei quali sono stati ritrovati intatti durante gli scavi archeologici del ventesimo secolo. I magazzini, chiamati horrea, si estendevano per decine di ettari intorno al bacino, con altezze che raggiungevano i quindici metri. Erano suddivisi in celle numerate, ciascuna dedicata a un tipo specifico di merce: grano, olio d'oliva, vino, garum (la celebre salsa di pesce romana), legname, metalli preziosi, marmi e persino animali esotici destinati ai giochi dell'anfiteatro. Le anfore ritrovate a Portus portano ancora oggi i bolli dei produttori e dei mercanti, offrendo agli archeologi una mappa dettagliata delle rotte commerciali dell'epoca. Una delle scoperte più affascinanti è quella di un horrea specializzato nell'olio d'oliva proveniente dalla Betica, l'odierna Andalusia, dove sono state recuperate oltre cinquemila anfare integre impilate ancora negli originali scaffali di legno fossilizzato.
La vita quotidiana tra scaricatori, mercanti e funzionari imperiali
A Portus non si muovevano solo merci, ma anche decine di migliaia di persone che vivevano e lavoravano in questo gigantesco complesso portuale. I saccarii, gli scaricatori specializzati nel trasporto dei sacchi di grano, formavano una corporazione potente e ben organizzata, con propri statuti, un dio protettore (Ercole) e persino una cassa comune per i funerali dei membri più poveri. Un'iscrizione rinvenuta nel 1885 vicino al faro racconta di un certo Lucius Caecilius Phoebus, saccario di origine greca, che riuscì a diventare così ricco da farsi costruire un sepolcro monumentale lungo la via Ostiense. Accanto ai saccarii lavoravano i navicularii, gli armatori che possedevano le navi e stipulavano contratti con lo stato per il trasporto del grano. Questi uomini appartenevano all'élite provinciale, spesso ex schiavi arricchiti che avevano ottenuto la cittadinanza romana. La loro corporazione, la Corpus Naviculariorum, aveva sede in un grande edificio rettangolare con un cortile centrale, identificato dagli archeologi come la "Curia degli Armatori". Qui si tenevano le aste per gli appalti, si discutevano le tariffe e si risolvevano le dispute commerciali. I funzionari imperiali, guidati da un procuratore di rango equestre, vigilavano sulle operazioni doganali, riscuotendo una tassa del 2,5% sul valore di tutte le merci importate, il cosiddetto portorium. I registri di queste tasse, incisi su tavolette di legno cerato, sono stati conservati miracolosamente grazie alle acque anaerobicamente ricche di sostanze organiche del bacino. Oggi sono custoditi nei Musei Vaticani e offrono una finestra unica sui volumi di scambio dell'epoca: nel solo anno 113 dopo Cristo, passarono da Portus 1.200 navi granarie, 3.500 navi mercantili minori e oltre 20.000 imbarcazioni di cabotaggio.
| Tipologia di merce | Provenienza principale | Volume annuo stimato |
| Grano | Egitto, Africa Proconsolare | 150.000 tonnellate |
| Olio d'oliva | Betica (Spagna), Tripolitania | 40.000 tonnellate |
| Vino | Gallia Narbonense, Grecia, Creta | 30.000 ettolitri |
| Garum (salsa di pesce) | Lusitania (Portogallo), Mauretania | 5.000 tonnellate |
| Marmi e graniti | Egitto, Grecia, Asia Minore | 10.000 blocchi |
Il faro di Portus e la tecnologia navale romana
Il faro di Portus, noto come "Turris Herculis" (Torre di Ercole), era una struttura imponente alta circa quaranta metri, costruita in blocchi di pietra vulcanica e rivestita di marmo bianco. Sulla sua sommità bruciava giorno e notte un fuoco alimentato a legna di pino e nafta, il cui riflesso poteva essere visto fino a venti miglia al largo, guidando i marinai attraverso le insidiose secche del delta del Tevere. La tecnologia nautica romana raggiunse a Portus il suo massimo splendore: le navi granarie, chiamate "corbite", erano costruite con legno di cedro e quercia, con scafi lunghi fino a cinquanta metri e vele quadre tessute in lino egiziano. L'equipaggio tipico di una corbita era composto da trenta marinai, un capitano (magister navis), un timoniere (gubernator) e un agente di bordo che teneva i conti delle merci. La navigazione da Alessandria d'Egitto a Portus richiedeva dai quindici ai venti giorni con vento favorevole, ma poteva durare anche due mesi in caso di tempeste. I marinai romani non avevano bussole magnetiche, ma si orientavano con le stelle, con il colore dell'acqua e con l'osservazione degli uccelli migratori. Una pratica diffusa era quella di imbarcare a bordo una gabbia di corvi: quando i corvi venivano liberati, volavano dritti verso la terraferma più vicina, indicando la rotta. Il faro di Portus rimase in funzione per oltre quattro secoli, fino all'abbandono del porto intorno al sesto secolo dopo Cristo, quando le invasioni barbariche e la malaria resero insicura la regione. Le sue rovine sono ancora visibili oggi, sebbene inglobate nelle paludi bonificate nell'Ottocento. Gli scavi subacquei degli ultimi vent'anni hanno riportato alla luce decine di ancore di piombo, anfore perfettamente conservate e persino il relitto di una corbita con parte del carico ancora intatto, offrendo una testimonianza straordinaria di una delle più grandi imprese logistiche della storia umana.
Portus non fu solo un porto, ma il vero motore economico dell'impero romano, il luogo dove il grano diventava pane per i cittadini di Roma e dove le merci di tre continenti si incontravano, si scambiavano e ridisegnavano ogni giorno la geografia del potere. Per oltre quattrocento anni, i moli di Portus videro passare schiavi e senatori, mercanti e imperatori, tutti uniti da una stessa, semplice verità: senza quel porto, Roma sarebbe morta di fame.
 (p)Link
 Commenti
 Storico
 Stampa
Di Alex (del 15/06/2026 @ 16:00:00, in Storia Medioevo, letto 421 volte)
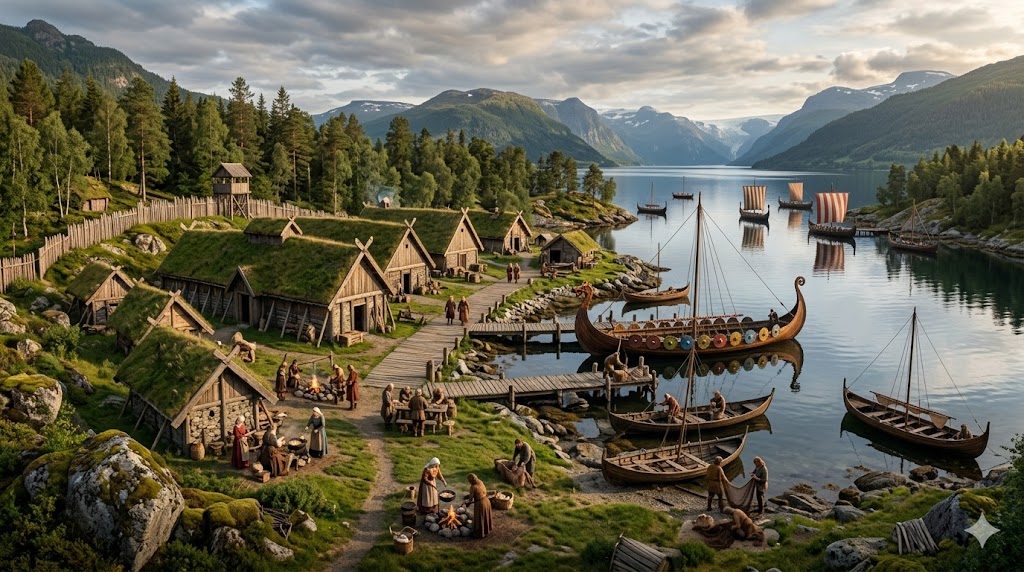
Un villaggio vichingo con donne che cucinano e uomini che costruiscono barche
Bonus Video
Longhouse e vita familiare: il cuore dell'insediamento
Il centro di ogni insediamento vichingo era la "longhouse", una lunga casa rettangolare costruita in legno (nelle regioni scandinave) o in pietra e torba (in Islanda e Groenlandia). Queste strutture potevano raggiungere i sessanta metri di lunghezza per sette di larghezza, e ospitavano una o più famiglie allargate, insieme agli animali domestici (mucche, pecore, capre, maiali) durante i rigidi inverni nordici. La longhouse era divisa in tre aree funzionali: all'ingresso si trovava la "skemma", una dispensa per gli attrezzi e le provviste; al centro, il "skali", la sala comune con un lungo focolare centrale (il "langeldr") che forniva calore e luce; in fondo, il "lokvistur", gli alloggi privati separati da tende di lana. Il focolare non si spegneva mai: veniva alimentato con torba o legna di betulla, e le ceneri erano usate come fertilizzante e come detergente. Sopra il focolare, un buco nel tetto (l' "ljóri") lasciava uscire il fumo, ma gran parte del fumo rimaneva all'interno, rendendo gli interni maleodoranti e irritanti per gli occhi. Le pareti erano rivestite di arazzi di lana (veggdúkr) che raccontavano storie di dei e di eroi, e il pavimento era coperto di paglia e pelli di pecora. La vita nella longhouse era comunitaria e rumorosa: bambini che giocavano, donne che filavano la lana, uomini che riparavano attrezzi, schiavi (thrall) che macellavano il cibo. I pasti venivano consumati seduti su lunghe panche di legno, davanti a tavoli bassi. Il cibo principale era la "grautr" (una zuppa di cereali con carne o pesce), accompagnata da pane azzimo cotto sotto la cenere, formaggio di capra e "skyr" (uno yogurt denso simile alla ricotta). La birra d'orzo (mjöð) e l'idromele erano le bevande comuni, ma solo nei banchetti si beveva vino importato dalla Francia o dalla Renania. I vichinghi erano molto attenti alla pulizia personale, contrariamente allo stereotipo: sono state rinvenuti pettini di corno, pinzette per sopracciglia, rasoi per barba e persino oggetti per pulire le orecchie nei siti archeologici. Le saghe norrene ricordano che "un uomo pulito e ben vestito era rispettato", e il sabato (laugardagr) era tradizionalmente il giorno del bagno, quando si frequentavano le saune pubbliche (surtarbað) presenti anche nei piccoli villaggi.
Bonus Video
Artigianato e commercio: la forza economica vichinga
L'immagine del vichingo come solo rapinatore è falsificata dalla storia scritta dai loro nemici (i monaci cristiani). In realtà, la maggior parte dei vichinghi erano commercianti, contadini e artigiani. Ogni insediamento aveva almeno un fabbro (smiðr), che forgiava chiodi, asce, coltelli e spade. La forgiatura delle spade era un'arte sacra: la lama era composta da diversi strati di acciaio (carburato) e ferro (dolce), intrecciati a formare un disegno chiamato "pattern welding". Una spada vichinga richiedeva mesi di lavoro e costava quanto dieci mucche, una fortuna. I fabbri più abili, come quelli della regione del Reno, erano famosi in tutta Europa. Accanto al fabbro, c'erano l' "skinnari" (conciatore di pelli), il "keramikari" (ceramista), il "trésmiðr" (falegname) e il "silfursmiðr" (orafo). I vichinghi erano esperti nell'intaglio del legno, come testimoniano i magnifici draghi delle navi e i dettagli decorativi delle longhouse. Il commercio vichingo si estendeva dall'Islanda alla Persia: le perline di vetro colorato (prodotte a Ribe e a Birka) sono state ritrovate in tombe dell'Asia centrale; il rame dall'odierno Afghanistan e l'argento dalle miniere del Califfato arrivavano nei villaggi vichinghi attraverso la "via variaga" dai fiumi russi verso il Mar Caspio. I vichinghi usavano come moneta i "dirham" arabi, che tagliavano in piccoli pezzi (hacksilver) per le transazioni quotidiane. Un tipico mercato vichingo (kaupang) vendeva pellicce di zibellino e di volpe artica (preziose nel Mediterraneo), denti di tricheco (lavorati come scacchi), avorio di balena, ambra grigia (usata in profumeria), grasso di foca per le lampade, e naturalmente schiavi europei (principalmente slavi, da cui deriva la parola "slave" in inglese). Ma la merce più richiesta erano le armi e le navi. I vichinghi costruivano due tipi di navi: i "knörr" (navi da carico larghe e robuste) e i "langskip" (navi da guerra lunghe e strette, con equipaggio fino a cento uomini). La costruzione di una nave richiedeva la collaborazione di tutto il villaggio: i taglialegna procuravano la quercia, i falegnami curvavano le tavole con il vapore, le donne cucivano le vele di lana, i fabbri forgiavano i rivetti di ferro. Una nave era la proprietà più preziosa di una comunità, e il suo capo (hersir) veniva sepolto con essa, come nel celebre ritrovamento di Oseberg.
Bonus Video
| Mestiere | Strumenti tipici | Prodotto principale |
| Fabbro | Maglio, incudine, mantice | Spade, asce, chiodi |
| Conciatore | Cortecce di salice, rasoi | Pelli di mucca e pecora |
| Orafo | Stampo, cesello, bilancia a piatti | Gioielli in argento e bronzo |
| Tessitrice | Telaio verticale, navetta, pesi da telaio | Vele di lana, vestiti |
Donne vichinghe: potere, eredità e libertà
Le donne vichinghe godevano di uno status sorprendentemente elevato rispetto ad altre società europee altomedievali. Potevano possedere terre, richiedere il divorzio (se il marito le picchiava o le trascurava sessualmente per più di tre anni) ed ereditare alla pari dei fratelli. Le saghe raccontano di donne guerriere chiamate "skjaldmö" (scudiere), come la leggendaria Lagertha o la storica Freydís Eiríksdóttir, che combatté contro i nativi americani a Vinland. Sebbene l'idea delle "shieldmaiden" sia stata a volte romanticizzata, gli archeologi hanno trovato tombe femminili con armi: la più celebre è la tomba di Birka (Svezia), dove una donna di alto rango fu sepolta con una spada, un'ascia, due lance e un cavallo. Le analisi del DNA del 2017 hanno confermato che si trattava di una donna, non di un uomo. Nella vita quotidiana, le donne gestivano la fattoria quando gli uomini erano in mare per mesi. Avevano il controllo della produzione tessile, che era la principale industria domestica: per tessere una vela di sessanta metri quadrati per una nave, servivano circa duecento chilogrammi di lana e un anno di lavoro di dieci donne. Le donne vichinghe indossavano lunghi abiti di lana (serk) con un grembiule (smokk) trattenuto da due spille ovali in bronzo (la cosiddetta "fibula a guscio di tartaruga"), spesso finemente decorate. Le spille non erano solo gioielli, ma anche simbolo di status e di ricchezza: potevano essere d'argento o d'oro e venivano trasmesse in eredità di madre in figlia. Le donne si prendevano cura anche dei bambini, che venivanno allattati fino ai due o tre anni (come indicato dalle analisi isotopiche degli scheletri) e poi educati al lavoro. I bambini vichinghi giocavano con piccole asce di legno, bambole di stoffa e dadi di osso. Imparavano presto a nuotare, a montare a cavallo e a maneggiare armi leggere. A dodici anni, un ragazzo veniva considerato adulto e poteva partecipare alle spedizioni (víking), mentre una ragazza veniva promessa in sposa. I matrimoni vichinghi erano affari politici ed economici: la famiglia dello sposo pagava una "mundr" (dote) alla famiglia della sposa, che a sua volta riceveva una "heimanfylgja" (dote dalla sua famiglia). Il divorzio, se richiesto dalla moglie, prevedeva che lei dichiarasse la separazione davanti a testimoni e uscisse dalla longhouse con la sua dote. Un caso celebre nelle saghe è quello di Gudrún Ósvífursdóttir, che divorziò dal marito per violenza e poi sposò il suo amante, scatenando una faida durata tre generazioni. La libertà femminile era limitata solo dalla religione: le donne non potevano essere sacerdotesse (gydja) se non in culti minori, ma potevano essere veggenti (völva), figure molto rispettate che sedevano su palchi alti e profetizzavano il futuro.
I Vichinghi non furono solo i "flagelli di Dio" che terrorizzarono i monasteri europei, ma un popolo di contadini navigatori, commercianti coraggiosi e artigiani capaci. La loro società, per molti versi più equa e aperta di quella dell'Europa cristiana, ci lascia un'eredità importante: che la libertà e l'autodeterminazione sono valori universali, anche in capanne di fumo e di ghiaccio, ai confini del mondo conosciuto.
Di Alex (del 15/06/2026 @ 17:00:00, in Storia Impero Romano, letto 409 volte)
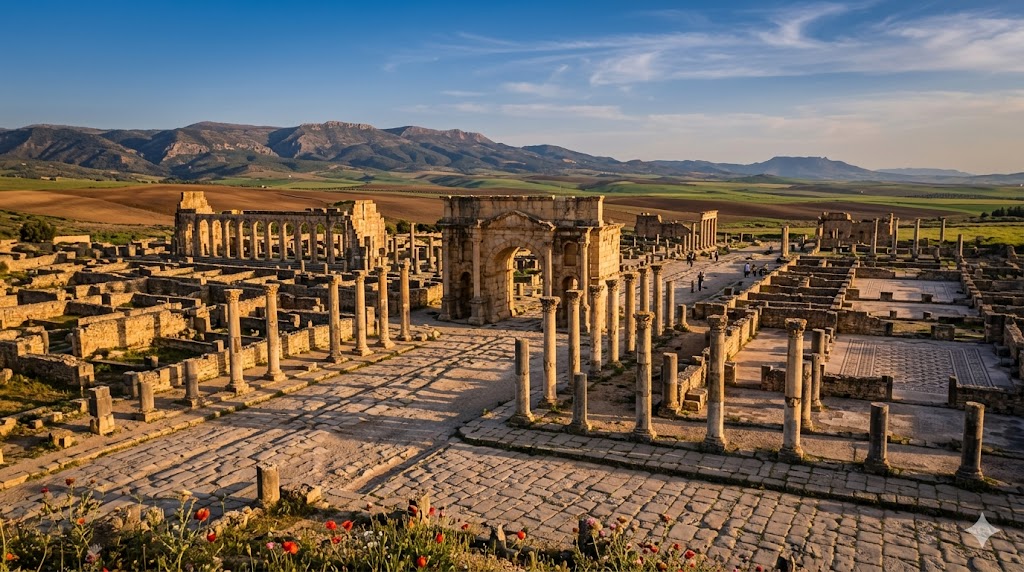
Le rovine di Volubilis con l'arco di Caracalla e le colonne del foro
Bonus Video
Dalla capitale berbera alla città romana: la storia di Volubilis
Volubilis, situata su un'altura tra i fiumi Khoumane e Fertassa nell'odierno Marocco, ha una storia che precede l'arrivo dei Romani di almeno quattro secoli. Era originariamente una capitale del regbero berbero di Mauretania, sotto il regno di Giuba II, il re colto e filo-romano che sposò Cleopatra Selene, figlia di Cleopatra d'Egitto e Marco Antonio. Quando l'imperatore Claudio annesse la Mauretania nel 44 dopo Cristo, trasformandola nella provincia romana della Mauretania Tingitana, Volubilis fu scelta come centro amministrativo principale grazie alla sua posizione strategica e alla sua prosperità economica. La città conobbe un periodo di straordinaria crescita tra il primo e il terzo secolo dopo Cristo, diventando il centro produttivo dell'olio d'oliva più importante di tutta l'Africa settentrionale. Le case patrizie si estendevano per oltre mille metri quadrati, decorate con mosaici tra i più belli del mondo romano. L'arco di trionfo di Caracalla, eretto nel 217 dopo Cristo, segnava l'ingresso occidentale alla città ed era sormontato da una quadriga di bronzo dorato, di cui oggi restano solo le colonne di marmo. Il foro, situato nel cuore della città, misurava quaranta metri per ventidue ed era circondato da portici e statue onorarie. La basilica giudiziaria, lunga settantasei metri e larga diciassette, era uno degli edifici pubblici più grandi di tutta la provincia, capace di ospitare oltre cinquecento persone per le udienze dei tribunali. Volubilis aveva anche un complesso termale monumentale, le Terme di Gallieno, con vasche in marmo bianco e pavimenti riscaldati, un tempio capitolino dedicato a Giove, Giunone e Minerva, e un quartiere residenziale noto come "quartiere degli efebi" per la splendida statua bronzea di un giovane atleta ivi rinvenuta durante gli scavi francesi degli anni Trenta del Novecento.
L'oro verde di Volubilis: la produzione dell'olio d'oliva
Ciò che rese Volubilis eccezionalmente ricca fu la produzione di olio d'oliva, il cosiddetto "oro verde" del Mediterraneo. Le pianure circostanti erano coperte da decine di migliaia di ulivi, molti dei quali esistevano già prima dell'arrivo dei Romani. Gli archeologi hanno identificato nei dintorni di Volubilis oltre cinquanta frantoi (torcularia), ciascuno in grado di produrre fino a diecimila litri di olio all'anno. La tecnologia romana della pressatura era sorprendentemente efficiente: le olive venivano schiacciate da una macina rotante in pietra vulcanica, poi la polpa veniva pressata utilizzando un lungo braccio di legno azionato da un contrappeso o da una vite in legno. L'olio raccolto veniva versato in anfore di terracotta di capacità standardizzata (settanta litri), sigillate con un tappo di sughero e un bollo che indicava il produttore, l'anno e il peso. Da Volubilis, le anfore venivano trasportate su carri fino al porto fluviale di Sala (l'odierna Rabat), quindi imbarcate per la Spagna, la Gallia e l'Italia. La qualità dell'olio di Volubilis era rinomata in tutto l'impero: fonti letterarie (Plinio il Vecchio, Historia Naturalis) lo descrivono come "viridissimo, di sapore fruttato con note di mandorla", ideale per cucinare ma anche per la cosmesi e per le lampade ad olio. L'olio di Volubilis era anche utilizzato nei riti religiosi: una grande iscrizione dedicatoria rinvenuta nel foro ricorda che un certo Marcus Valerius Severus donò al tempio di Giove duemila anfore di olio (centoquarantamila litri) per i giochi in onore dell'imperatore. Oltre all'olio, Volubilis esportava grano, fichi secchi, datteri, e una specialità locale: la "liquamen", una salsa di pesce simile al garum ma preparata con pesci dell'Atlantico. Le anfore di Volubilis sono state rinvenute in siti archeologici lontani come Londinium (Londra) e Colonia Agrippina (Colonia), a testimonianza dell'ampiezza dei commerci della città.
| Prodotto | Produzione annua stimata | Destinazione principale |
| Olio d'oliva | 500.000 litri | Roma, Spagna, Gallia |
| Grano | 10.000 tonnellate | Legioni della Mauretania |
| Liquamen (salsa di pesce) | 5.000 anfore | Italia |
| Pelli conciate | 20.000 pelli | Esercito romano |
Mosaici, domus e vita aristocratica a Volubilis
La ricchezza dell'olio d'oliva si rifletteva nelle sfarzose domus (case patrizie) di Volubilis, le cui pavimentazioni musive sono tra le meglio conservate di tutto il mondo romano. La Casa dei Lavori di Ercole, una residenza di oltre duemila metri quadrati, prende il nome dal ciclo di mosaici che decorano il triclinio (sala da pranzo), raffigurante le dodici fatiche dell'eroe mitologico. Le scene sono eseguite con tessere di meno di cinque millimetri, utilizzando marmi colorati provenienti da Numidia, Grecia e Asia Minore. La Casa del Cavaliere, invece, prende il nome da un mosaico raffigurante un cavaliere che uccide un leone, simbolo del potere e del coraggio. In questa domus, gli archeologi hanno scoperto un tesoro di cinquantasette monete d'oro (aurei) risalenti al terzo secolo dopo Cristo, nascoste in un'anfora sotto il pavimento della cucina, probabilmente al momento dell'abbandono della città. La vita nelle domus di Volubilis era scandita dai ritmi del "cursus honorum" (la carriera politica locale). I patrizi si alzavano all'alba, ricevevano i clienti nella "tablinum" (studio), poi si recavano al foro per assistere alle riunioni della curia (il senato locale). Il pranzo (cena) era il pasto principale, servito nel tardo pomeriggio, con portate che potevano includere uova, ostriche, carni arrosto (cinghiale, capretto, maiale), pesce di fiume e dolci al miele e semi di papavero. Il tutto annaffiato da vino di Tangeri, un vino dolce e liquoroso apprezzato anche a Roma. Le donne delle classi alte gestivano la casa e l'educazione dei figli, ma alcune di esse, come la famosa Volusia Tertia di cui abbiamo una lunga iscrizione funeraria, gestivano direttamente le loro proprietà terriere e presiedevano associazioni religiose. Volubilis conobbe un lento declino a partire dal terzo secolo dopo Cristo, quando le pressioni delle tribù berbere non romanizzate (i Mauri) resero insicura la regione. L'imperatore Settimio Severo, nativo di Leptis Magna (Libia), concesse a Volubilis lo status di municipio nel 201 dopo Cristo, ma la città fu evacuata dalle truppe romane intorno al 280 dopo Cristo. Tuttavia, la città continuò a vivere sotto i governatori berbero-romani e poi sotto la dominazione islamica fino all'undicesimo secolo, quando fu definitivamente abbandonata. Oggi, le sue rovine sono patrimonio dell'UNESCO e uno dei siti archeologici più suggestivi del Nord Africa.
Volubilis racconta una storia dimenticata dei manuali: quella di un'Africa romana prospera, colta e multiculturale, dove i contadini berberi e i patrizi latini condividevano la stessa terra e lo stesso destino. I suoi mosaici, sfiniti dal sole ma ancora vivi nei colori, sono l'ultimo sorriso di una civiltà che ha saputo fare dell'olio, del commercio e della bellezza la sua ragion d'essere.
Di Alex (del 16/06/2026 @ 08:00:00, in Storia Impero Romano, letto 524 volte)
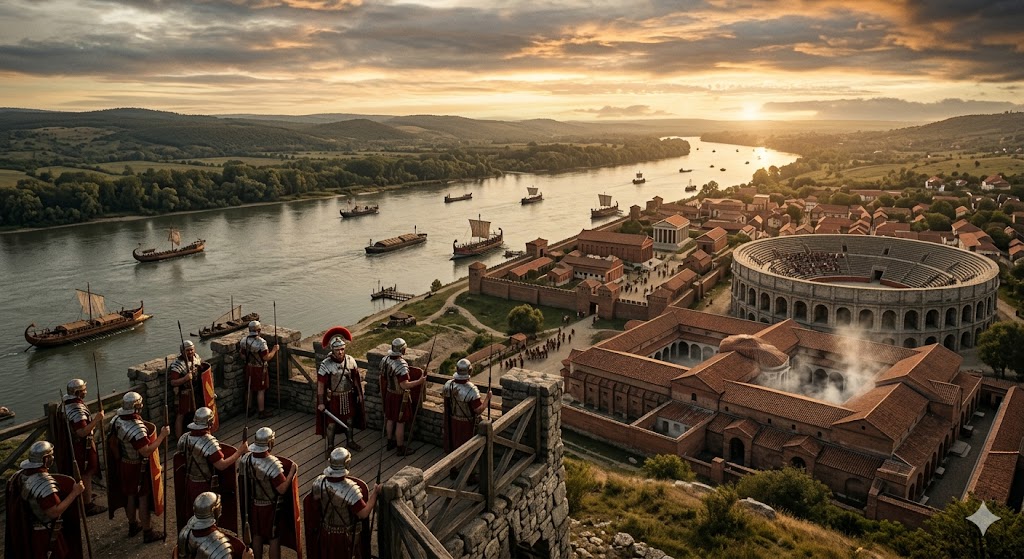
Rovine di Aquincum con l’anfiteatro e le terme sullo sfondo del Danubio
Bonus Video
Dalla fortezza di legno alla capitale provinciale
Le prime tracce di presenza romana nel sito dell’odierna Budapest risalgono all’89 dopo Cristo, quando una vexillatio della legione II Adiutrix costruì un castrum di terra e legno su un terrazzo alluvionale che dominava il guado del Danubio. La posizione, all’incrocio tra la via fluviale e la strada che conduceva ai Carpazi, fece di Aquincum il perno logistico del limes pannonicus, il sistema di fortezze, torri di segnalazione e strade militari che proteggeva l’Italia da eventuali invasioni dai Balcani settentrionali. Sotto Traiano, attorno al 106 dopo Cristo, la città ottenne lo statuto di municipium, e con Adriano divenne colonia, titolo che portava con sé il diritto italico e l’esenzione dalle imposte fondiarie, accelerando l’afflusso di veterani e commercianti dalla Cisalpina.
Le planimetrie archeologiche mostrano una maglia ortogonale di strade lastricate in basalto, fiancheggiate da portici e tabernae, che si irradiava dal foro centrale, dove sorgevano la basilica civile e il tempio di Giove Dolicheno. L’acquedotto, lungo circa otto chilometri, captava le sorgenti dei monti Pilis e alimentava una rete di fontane pubbliche, terme e latrine, con una portata stimata di duemila metri cubi al giorno. I resti delle terme maggiori, ancora visitabili nel parco archeologico, rivelano un impianto a ipocausto con pavimenti in opus sectile e vasche rivestite di marmo di Proconneso, che non sfigurerebbero in una villa senatoria di Roma.
La vita sul limes tra pace e guerra
Aquincum era separata dal Barbaricum solo dal Danubio, che in quel tratto raggiungeva una larghezza di trecento metri e veniva pattugliato da una flotta fluviale composta da liburnae e naves actuariae. Sulle due rive si fronteggiavano due mondi: a ovest i vigneti e i campi coltivati dei coloni italici, a est le tende di feltro degli Iazigi e le mandrie di cavalli dei Sarmati Roxolani, con i quali si alternavano periodi di guerra e di vivace commercio di schiavi e pellicce.
Gli scavi delle necropoli hanno restituito stele funerarie che narrano storie di integrazione: un mercante siriano di Antiochia che sposò una donna celtica e divenne decurione, un medico greco che curava i gladiatori dell’anfiteatro e un centurione di origine batava che dedicò un’ara al dio Mitra. L’anfiteatro militare, costruito nella prima metà del II secolo dopo Cristo, poteva ospitare seimila spettatori e fu teatro di venationes e munera gladiatoria, come attestano i graffiti dei combattenti incisi sulle pareti dei carceres. Accanto sorgeva l’anfiteatro civile, di poco più piccolo, destinato ai giochi offerti dai magistrati locali.
| Edificio | Capacità | Datazione | Stato di conservazione |
|---|---|---|---|
| Terme maggiori | 1.200 m² | 130 dopo Cristo | Restaurate e visitabili |
| Anfiteatro militare | 6.000 spettatori | 140 dopo Cristo | Arena e gradinate parziali |
| Anfiteatro civile | 4.500 spettatori | 160 dopo Cristo | Ruderi consolidati |
| Santuario di Mitra | 80 m² | 210 dopo Cristo | Ben conservato |
| Porta praetoria | 12 m altezza | 89 dopo Cristo | Ricostruita nel XIX secolo |
Il tramonto e l’eredità magiara
Aquincum subì gravi danni durante le guerre marcomanniche, ma fu ricostruita sotto Settimio Severo e conobbe un ultimo periodo di fioritura nel IV secolo dopo Cristo, quando divenne sede di una zecca imperiale e di una fabbrica di scudi. Il definitivo abbandono avvenne nel 409 dopo Cristo, quando i Visigoti di Alarico devastarono la Pannonia, e le rovine vennero progressivamente coperte dalle alluvioni del Danubio. Oggi il Museo di Aquincum conserva una delle più ricche collezioni di organi idraulici romani mai rinvenuti, e il parco archeologico, inserito nel 2022 nella lista del patrimonio mondiale dell’UNESCO, offre un affresco vivido di come la periferia dell’impero non fosse una terra di esilio ma un crocevia di culture in costante trasformazione. Aquincum dimostra che la forza di Roma non risiedeva solo negli eserciti ma nella capacità di creare comunità coese ai confini del mondo conosciuto, fondendo tradizioni italiche, celtiche e orientali in un modello di urbanità che ancora oggi sorprende per modernità e resilienza.

Confronto tra Asus TUF A14 e MacBook Pro M5 in uno studio di rendering 3D
Bonus Video
Analisi dei processori e delle architetture core
Il microprocessore AMD Ryzen AI 7 350 rappresenta il cuore computazionale dell'Asus TUF Gaming A14 FA401KM ed appartiene alla famiglia di APU "Krackan Point" realizzata con il processo tecnologico FinFET a 4 nm di TSMC. Questa architettura ibrida integra 8 core fisici e 16 thread grazie alla tecnologia Simultaneous Multithreading, con una ripartizione che prevede 4 core prestazionali Zen 5 capaci di raggiungere una frequenza massima di boost pari a 5,0 GHz e 4 core densi Zen 5c ottimizzati per l'efficienza energetica, operanti con un clock massimo di 3,5 GHz. Il chip dispone di 16 MB di cache L3 condivisa e 8 MB di cache L2, mentre il Thermal Design Power di base è fissato a 28 W, configurabile dinamicamente dai produttori in un intervallo compreso tra 15 W e 54 W a seconda del profilo termico adottato dal notebook. Ad affiancare la CPU vi è una NPU AMD XDNA 2 integrata capace di erogare fino a 50 TOPS di potenza di calcolo dedicata ai modelli di intelligenza artificiale locali, con un valore combinato di piattaforma che raggiunge fino a 66 TOPS.
L'architettura proprietaria Apple Silicon M5 costituisce un salto generazionale basato sul processo produttivo a 3 nm di TSMC. Il chip M5 di base integra una CPU a 10 core complessivi, suddivisi in 4 "super core" prestazionali e 6 core ad alta efficienza energetica. I super core beneficiano di una riprogettazione del front-end, di una nuova gerarchia di cache e di un'unità di branch prediction ottimizzata per massimizzare le prestazioni single-thread. Salendo nella gamma, il chip M5 Pro adotta la Fusion Architecture, accoppiando due die fisici tramite interconnessioni ad altissima velocità per offrire configurazioni fino a 18 core CPU, con 6 super core e 12 performance core. Il chip top di gamma M5 Max mantiene la medesima struttura a 18 core ma raddoppia le risorse grafiche e la larghezza di banda del bus di memoria unificata, posizionandosi come la soluzione più potente per carichi di lavoro intensivi.
Una delle differenze architetturali più rilevanti risiede nel sottosistema di memoria. L'Asus TUF Gaming A14 FA401KM è limitato da una memoria LPDDR5X saldata sulla scheda madre operante a 7500 MHz, configurata in dual-channel con una capacità massima non aggiornabile di 16 GB. L'architettura Apple M5 si affida a memorie unificate LPDDR5X a 9600 MT/s integrate direttamente nel package del SoC, condivise dinamicamente tra CPU, GPU e Neural Engine grazie al sistema di allocazione unificata. La larghezza di banda passante teorica della memoria può essere calcolata tramite l'equazione che mette in relazione frequenza DRAM, ampiezza del bus e numero di canali, e applicando la formula alle diverse configurazioni hardware analizzate si ottengono valori di targa che mostrano un vantaggio computazionale netto per Apple Silicon in termini di throughput di memoria, con l'M5 Max che offre una larghezza di banda oltre cinque volte superiore rispetto alla memoria saldata dell'Asus TUF, un fattore che si rivela determinante nell'elaborazione di dataset di grandi dimensioni e nell'inferenza di modelli linguistici locali.
| Caratteristica Architetturale | AMD Ryzen AI 7 350 (Asus TUF) | Apple M5 (Base) | Apple M5 Pro | Apple M5 Max |
| Processo Produttivo | TSMC 4nm FinFET | TSMC 3nm (Seconde Gen) | TSMC 3nm (Fusion Die) | TSMC 3nm (Fusion Die) |
| Configurazione Core (CPU) | 4x Zen 5 + 4x Zen 5c | 4 Super Core + 6 Efficiency | 6 Super Core + 12 Performance | 6 Super Core + 12 Performance |
| Thread Totali | 16 (SMT Attivo) | 10 (Single-Threaded Cores) | 18 (Single-Threaded Cores) | 18 (Single-Threaded Cores) |
| Frequenza di Clock | Da 2,0 GHz a 5,0 GHz | Fino a 4,6 GHz | Fino a 4,6 GHz | Fino a 4,6 GHz |
| Cache Integrata | 16MB L3 + 8MB L2 | Struttura proprietaria | Struttura proprietaria | Struttura proprietaria |
| Tecnologia di Memoria | LPDDR5X-7500 (Saldata) | LPDDR5X-9600 (SoC unificata) | LPDDR5X-9600 (SoC unificata) | LPDDR5X-9600 (SoC unificata) |
| Capacità Massima RAM | 16 GB | 32 GB | 64 GB | 128 GB |
| Canali e Ampiezza Bus | Dual-Channel (128-bit) | Dual-Channel (128-bit) | Quad-Channel (256-bit) | Octa-Channel (512-bit) |
| Potenza di Calcolo NPU | 50 TOPS (XDNA 2) | 16-Core Neural Engine | 16-Core Neural Engine | 16-Core (Banda Elevata) |
Benchmark di elaborazione con Geekbench 6.0 e analisi della GPU
I test comparativi eseguiti tramite la suite software Geekbench 6.0 evidenziano un divario prestazionale netto sia sul calcolo generico della CPU sia sul versante della grafica computazionale, con risultati che ridefiniscono le aspettative per entrambe le piattaforme. Il processore AMD Ryzen AI 7 350 installato sull'Asus TUF Gaming A14 FA401KM registra punteggi sintetici medi di circa 2.677 punti nel test Single-Core e 11.742 punti nel test Multi-Core. Sebbene queste metriche collochino la piattaforma x86 di AMD in una fascia competitiva rispetto alle generazioni precedenti, superando l'architettura Intel Lunar Lake Core Ultra 7 258V, l'efficienza d'istruzione per ciclo d'orologio di Apple Silicon si rivela superiore in ogni scenario misurato.
Il chip Apple M5 di base mette a referto un punteggio di 4.263 punti in Single-Core e 17.862 punti in Multi-Core. In ambito Single-Core, l'M5 stacca il Ryzen AI 7 350 del 59 per cento, facendo registrare il punteggio a thread singolo più alto mai rilevato nel database di Geekbench 6.0 per processori consumer di questa categoria. In ambito Multi-Core, l'incremento prestazionale a favore di Apple si attesta sul 52 per cento, a dimostrazione della bontà del design a 10 core complessivi. L'estensione della gamma verso i chip a elevato numero di core evidenzia la scalabilità della Fusion Architecture: l'Apple M5 Max, configurato con una CPU a 18 core, raggiunge un punteggio multi-thread straordinario di 29.233 punti, superando del 148 per cento la CPU dell'Asus TUF e battendo soluzioni desktop multithread ad alte prestazioni.
L'Asus TUF Gaming A14 FA401KM si affida alla scheda grafica dedicata di nuova generazione NVIDIA GeForce RTX 5060 Laptop, basata sull'architettura Blackwell con chip GB206 a 5 nm di TSMC, dotata di 3.328 core CUDA, 104 Tensor core di quinta generazione e 26 core Ray Tracing di quarta generazione. La scheda dispone di 8 GB di memoria VRAM di tipo GDDR7 dedicata operante su un bus di memoria a 128 bit, garantendo una larghezza di banda pari a 384 GB/s. Sulla piattaforma TUF, la GPU è configurata per funzionare a una frequenza massima di 1.737 MHz con un TGP di 105 W, suddivisi in 90 W stabili e 15 W allocati dinamicamente tramite NVIDIA Dynamic Boost. Nel benchmark di calcolo grafico Geekbench 6.0 OpenCL, la RTX 5060 Laptop fa registrare punteggi compresi tra 102.564 e 109.431 punti in base al sistema ospitante e alla dissipazione termica disponibile.
La GPU integrata da 10 core dell'Apple M5 base registra un punteggio nel benchmark grafico proprietario Metal di circa 76.727 punti, mostrando un'efficienza straordinaria in rapporto al consumo energetico ma senza poter competere con la potenza bruta e i canali di calcolo parallelo della RTX 5060 dedicata a pieno voltaggio. Salendo alle soluzioni di fascia alta, Apple colma il divario grazie al raddoppio hardware dei core grafici: la GPU a 40 core integrata nell'Apple M5 Max esegue il test Metal totalizzando punteggi compresi tra 218.772 e 232.718 punti, superando del 110 per cento le capacità di elaborazione della RTX 5060 mobile nativa, pur mantenendo un consumo energetico complessivo del sistema decisamente più basso grazie all'architettura di caching dinamico di seconda generazione e al mesh shading con accelerazione hardware.
| Metriche di Benchmark (Geekbench 6.0) | Asus TUF (Ryzen AI 7 350 + RTX 5060) | Apple MacBook Pro 14" (M5 Base) | Apple MacBook Pro 14" (M5 Max) |
| CPU Single-Core (Punti) | ~2.677 | ~4.263 | ~4.268 |
| CPU Multi-Core (Punti) | ~11.742 | ~17.862 | ~29.233 |
| GPU Compute - OpenCL (Punti) | ~105.000 (NVIDIA Dedicated) | Non Rilevante | ~132.000 (Apple Silicon) |
| GPU Compute - Metal (Punti) | Non Supportato | ~76.727 (Apple Integrated) | ~225.000 (Apple Integrated) |
| PassMark G3D Mark (Punti) | ~16.798 (RTX 5060) | Non Rilevante | Non Rilevante |
Archiviazione SSD e prestazioni delle interfacce USB e Thunderbolt
La reattività globale del sistema e la rapidità nel trasferimento di file pesanti, come librerie di texture 3D o progetti CAD, sono determinate dalle prestazioni dei canali di memorizzazione e dalle interfacce di espansione fisiche, ed è proprio in questo ambito che emergono differenze sostanziali tra le due piattaforme. L'Asus TUF Gaming A14 FA401KM adotta una configurazione di archiviazione basata su un'unità a stato solido M.2 NVMe PCIe Gen 4x4 da 1 TB. Nei benchmark di lettura e scrittura sequenziale eseguiti tramite PassMark o AS SSD, l'unità preinstallata di classe Micron registra velocità tipiche di circa 2.168 MB/s in lettura sequenziale e 1.725 MB/s in scrittura sequenziale. Gli utenti che decidono di aggiornare l'unità con SSD di fascia alta, come il Kingston NV3 PCIe 4.0, possono raggiungere velocità di targa fino a 6.000 MB/s in lettura e 5.000 MB/s in scrittura, ma le prestazioni reali di copia di file ad alta capacità si attestano su valori più contenuti: nel test standardizzato di trasferimento di un pacchetto di dati da 25 GB, la piattaforma Asus TUF registra una velocità media sostenuta di scrittura di soli 1.520,83 MB/s.
Un limite architetturale importante dell'Asus TUF risiede nello schema di cablaggio dei canali PCIe sulla scheda madre. Sebbene il laptop offra due slot fisici M.2 2280 NVMe per l'espansione della memoria fino a 4 TB totali, le limitazioni della piattaforma del processore AMD forzano il secondo slot a operare esclusivamente a velocità ridotta PCIe 4.0 x2. Di conseguenza, qualsiasi SSD ad alte prestazioni installato nel secondo alloggiamento vedrà dimezzata la sua larghezza di banda potenziale, creando un collo di bottiglia significativo per i professionisti che necessitano di archiviare grandi moli di dati.
L'ecosistema Apple Silicon M5 implementa un'architettura di archiviazione proprietaria ad altissimo rendimento, nella quale il controller dell'SSD non è integrato nell'unità di memorizzazione stessa ma è inserito direttamente sul silicio del SoC M5, consentendo a macOS di gestire la memoria NAND con una latenza ridotta e una conoscenza diretta del file system. Il chip Apple M5 Base utilizza una connessione PCIe Gen 5.0 x2 che consente di raggiungere velocità sequenziali nel test Blackmagic Disk Speed di circa 6.323 MB/s in lettura e 6.068 MB/s in scrittura, segnando un incremento prestazionale in lettura fino al 211 per cento rispetto alla passata generazione M4. I chip M5 Pro e M5 Max sfruttano un'interfaccia PCIe Gen 5.0 x4 e una maggiore parallelizzazione dei chip NAND flash, soprattutto nei tagli da 4 TB o superiori. I test eseguiti sul campo rivelano velocità di lettura sostenuta pari a 13,6 GB/s e velocità di scrittura di ben 17,8 GB/s. I moduli ad altissima capacità da 8 TB beneficiano di un numero ancora maggiore di canali e planes NAND paralleli, raggiungendo una larghezza di banda di trasferimento record vicina ai 22 GB/s.
La dotazione di porte dell'Asus TUF Gaming A14 FA401KM offre un mix di interfacce veloci e legacy che richiedono attenzione da parte dell'utente per evitare colli di bottiglia: una porta Type-C USB 4 operante a 40 Gbps con supporto all'uscita video DisplayPort e al protocollo Power Delivery, una porta Type-C USB 3.2 Gen 2 limitata a 10 Gbps con supporto DisplayPort e G-Sync, due porte Type-A USB 3.2 Gen 2 operanti a 10 Gbps, un'uscita video HDMI 2.1 FRL e un lettore di schede MicroSD UHS-II in grado di raggiungere una velocità teorica di 312 MB/s. La discrepanza tra le due porte Type-C è notevole: l'utilizzo di una docking station o di un box SSD esterno ad alta velocità fornirà prestazioni ottimali solo se collegato alla specifica porta USB4, mentre la porta USB 3.2 Gen 2 ne ridurrà le prestazioni a un quarto della velocità teorica.
Il MacBook Pro 14 pollici con chip M5 di base offre tre porte Thunderbolt 4 Type-C, ciascuna delle quali fornisce una larghezza di banda simmetrica di 40 Gbps per dati e video DisplayPort 1.4, garantendo l'assenza di asimmetrie funzionali. Sono inoltre presenti una porta HDMI 2.1, uno slot per schede SDXC e un connettore MagSafe 3 per la ricarica rapida. Sulle configurazioni con chip M5 Pro e M5 Max, Apple integra controller fisici Thunderbolt dedicati a livello di chip per ciascuna singola porta, aggiornando le interfacce allo standard Thunderbolt 5, che offre fino a 80 Gbps di larghezza di banda bidirezionale simmetrica per trasferimenti di dati standard e fino a 120 Gbps di throughput grazie alla tecnologia Bandwidth Boost per scenari video intensivi, consentendo di gestire simultaneamente fino a tre schermi esterni ad alta risoluzione a 6K a 60 Hz attraverso un singolo cavo collegato a una docking station Thunderbolt 5.
| Parametro Hardware | Asus TUF A14 FA401KM | MacBook Pro 14" M5 Base | MacBook Pro 14" M5 Max |
| Interfaccia SSD Interna | PCIe Gen 4x4 (Slot 1) / Gen 4x2 (Slot 2) | PCIe Gen 5.0 x2 | PCIe Gen 5.0 x4 |
| Velocità Lettura Sequenziale | ~2.168 MB/s (Micron standard) | ~6.323 MB/s (Blackmagic) | ~13.600 MB/s (Sostenuta) |
| Velocità Scrittura Sequenziale | ~1.725 MB/s (Micron standard) | ~6.068 MB/s (Blackmagic) | ~17.800 MB/s (Sostenuta) |
| Porte ad Alta Velocità | 1x USB 4 (40 Gbps) | 3x Thunderbolt 4 (40 Gbps) | 3x Thunderbolt 5 (80/120 Gbps) |
| Porte Standard/Legacy | 1x USB-C (10 Gbps) + 2x USB-A (10 Gbps) | Nessuna (Adattatori Richiesti) | Nessuna (Adattatori Richiesti) |
| Uscita Video Integrata | HDMI 2.1 FRL | HDMI 2.1 | HDMI 2.1 (Supporto 8K) |
| Lettore di Schede Flash | MicroSD UHS-II (312 MB/s) | SDXC (Alta Velocità) | SDXC (Alta Velocità) |
Risoluzione del display, nitidezza e fedeltà cromatica
La resa visiva e la precisione millimetrica nella riproduzione spaziale delle geometrie e dei colori sono elementi fondamentali per i professionisti della grafica computazionale, e la differenza tra le due piattaforme in questo ambito è profonda. L'Asus TUF Gaming A14 adotta un pannello IPS opaco anti-glare da 14 pollici in formato 16:10 con risoluzione 2.5K WQXGA di 2.560 x 1.600 pixel. Lo schermo offre una frequenza di aggiornamento di 165 Hz, un tempo di risposta di 3 ms e la tecnologia di sincronizzazione dinamica G-Sync, coadiuvata da un MUX Switch fisico e NVIDIA Advanced Optimus per escludere la scheda video integrata e ridurre la latenza. La copertura cromatica è limitata al 100 per cento dello spazio sRGB, mentre la luminosità massima dichiarata è di 400 nits. I test di riflettanza indicano un valore di 50.5 GU, collocando il pannello in una classe a media riflettanza.
Sebbene la nitidezza e la reattività siano soddisfacenti per il gaming e i compiti generici, la tecnologia IPS mostra carenze evidenti in contesti di editing professionale: il rapporto di contrasto nativo non supera i 1.000:1, determinando neri che tendono al grigio scuro e una dinamica HDR praticamente assente a causa della retroilluminazione globale. Il MacBook Pro 14.2 pollici monta un display con tecnologia Liquid Retina XDR, basato su una matrice Mini-LED proprietaria che consente il controllo della luminosità a livello di zone microscopiche. La risoluzione nativa è di 3.024 x 1.964 pixel con una densità di 254 pixel per pollice. Le specifiche tecniche superano in modo netto le capacità del pannello IPS dell'Asus TUF: offre fino a 1.000 nits di luminosità sustained a schermo intero e ben 1.600 nits di picco durante la riproduzione di contenuti HDR. In contesti SDR all'aperto, la luminosità massima raggiunge i 1.000 nits, garantendo una leggibilità ottimale sotto la luce solare diretta.
Il rapporto di contrasto raggiunge un valore reale di 1.000.000:1, assicurando neri assoluti nelle aree d'ombra grazie allo spegnimento completo dei Mini-LED. Lo spazio colore copre interamente lo spettro cromatico ad ampia gamma DCI-P3 con una profondità di colore a 10 bit, equivalente a 1 miliardo di colori, e implementa la tecnologia True Tone insieme a ProMotion con refresh rate adattivo fino a 120 Hz. Per gli ambienti di lavoro caratterizzati da forti sorgenti di luce artificiale o naturale, è disponibile in opzione un vetro con trattamento a nano-texture antiriflesso, che riduce ulteriormente i disturbi visivi e migliora la concentrazione durante le lunghe sessioni di lavoro.
| Caratteristica del Display | Asus TUF A14 FA401KM | MacBook Pro 14" M5 |
| Dimensioni e Formato | 14.0 pollici (16:10) | 14.2 pollici (16:10, angoli arrotondati) |
| Risoluzione Nativa | 2.560 x 1.600 pixel (WQXGA) | 3.024 x 1.964 pixel |
| Densità di Pixel (ppi) | 215 ppi | 254 ppi |
| Tecnologia del Pannello | IPS-Level (Retroilluminazione Globale) | Mini-LED (Liquid Retina XDR) |
| Trattamento Superficie | Opaco Anti-Glare (Riflettanza 50.5 GU) | Lucido (Opzione Vetro con Nano-Texture) |
| Rapporto di Contrasto | ~1.000:1 (Nero IPS) | 1.000.000:1 (Nero Assoluto) |
| Luminosità Massima (SDR) | 400 nits | 1.000 nits (Outdoor sostenuta) |
| Luminosità Massima (HDR) | Non Rilevante (Scarsa resa HDR) | 1.600 nits (Picco dinamico) |
| Profondità e Spazio Colore | 8-bit, sRGB: 100.00% | 10-bit (P3 Wide Color), 1 miliardo di colori |
| Frequenza di Aggiornamento | 165Hz (Fissa o G-Sync) | 120Hz (ProMotion adattiva o frequenze fisse) |
Prestazioni in virtualizzazione: 3ds Max e Chaos V-Ray sotto Parallels su Mac
La valutazione dell'efficienza dei flussi di lavoro tridimensionali evidenzia l'insorgere di colli di bottiglia e incompatibilità hardware significative quando si tenta di eseguire suite di modellazione e rendering professionali in ambiente macOS virtualizzato, ed è proprio in questo contesto che la piattaforma Asus TUF mostra il suo vantaggio decisivo. Autodesk 3ds Max è un'applicazione software sviluppata storicamente in modo esclusivo per l'ambiente operativo Microsoft Windows x86-64, e non esiste alcuna versione compilata nativamente per macOS. Quando si esegue il programma su un MacBook Pro con processore Apple Silicon M5, è necessario utilizzare Parallels Desktop per creare una macchina virtuale basata sulla versione ARM64 di Windows 11. Poichè 3ds Max non dispone di un codice sorgente nativo ARM, il sistema operativo Windows virtualizzato deve applicare un layer di emulazione in tempo reale per tradurre le istruzioni x86-64 in comandi compatibili con l'architettura dei core ARM di Apple. Questa doppia transizione, che combina la virtualizzazione dell'Hypervisor con l'emulazione binaria, comporta un degrado prestazionale diretto della CPU stimato tra il 15 e il 30 per cento rispetto alle performance native del processore in ambiente macOS nativo.
La viewport di 3ds Max, il motore grafico integrato per la manipolazione e l'anteprima delle mesh 3D, si basa sull'API grafica Microsoft DirectX. L'architettura hardware di Apple Silicon non supporta nativamente le librerie DirectX, affidandosi esclusivamente alle proprie API proprietarie Metal. La scheda video virtuale emulata da Parallels Desktop su Apple Silicon introduce una limitazione critica: supporta al massimo le librerie DirectX 11.1 e OpenGL 4.1, senza alcun supporto per le API di nuova generazione DirectX 12 o Vulkan. Di conseguenza, 3ds Max è costretto a rinunciare alle ottimizzazioni del driver grafico avanzato Nitrous, che richiede DirectX 12. Nella pratica professionale, la manipolazione di scene moderatamente complesse, contenenti geometrie ad alto numero di poligoni, texture ad alta risoluzione o ombreggiature in tempo reale, risulta estremamente problematica: si verificano vistosi ritardi di redraw della viewport, stutters costanti durante le operazioni di rotazione o zoom della camera e frequenti crash dovuti a incompatibilità dei driver grafici virtualizzati. Autodesk dichiara ufficialmente 3ds Max come configurazione non supportata in ambienti virtuali, declinando qualsiasi supporto tecnico per bug generati sotto Parallels.
Chaos V-Ray rappresenta uno dei motori di rendering professionali più diffusi sul mercato, e la sua pipeline di rendering ad alte prestazioni, V-Ray GPU, è interamente ingegnerizzata per sfruttare le API proprietarie NVIDIA CUDA e NVIDIA OptiX. Poichè Apple Silicon utilizza una GPU integrata proprietaria priva di hardware NVIDIA, e Parallels Desktop esegue la virtualizzazione della GPU traducendo i comandi in chiamate Metal su macOS senza consentire un pass-through hardware diretto dei registri fisici della GPU, la macchina virtuale Windows non rileva alcun dispositivo grafico compatibile con CUDA. Di conseguenza, la modalità di calcolo V-Ray GPU risulta totalmente inagibile e disattivata su MacBook Pro operante sotto Parallels. L'utente è obbligato a ripiegare esclusivamente sulla modalità di rendering V-Ray CPU, ma l'elaborazione tramite processore virtualizzato sconta pesanti colli di bottiglia logici: la licenza Standard di Parallels Desktop limita l'allocazione delle risorse per la macchina virtuale a un massimo di 4 core vCPU e 8 GB di RAM virtuale, una quantità del tutto insufficiente per caricare geometrie complesse e texture 3D. Per sbloccare fino a 18 core vCPU e 62 GB di RAM è necessario sottoscrivere un abbonamento annuale ricorrente alla licenza Parallels Pro. Anche disponendo della licenza Pro, l'emulazione dei set di istruzioni vettoriali avanzati, come AVX-512 o AVX2, fondamentali per la velocità dei calcoli di ray-tracing di V-Ray, risulta rallentata rispetto all'esecuzione nativa su hardware x86. Il rendering interattivo si rivela scattoso, privo di reattività in tempo reale e inadatto a flussi di lavoro industriali, richiedendo tempi di calcolo dalle 2 alle 10 volte superiori rispetto al rendering GPU.
Sulla piattaforma Asus TUF Gaming A14 FA401KM, l'intero flusso di lavoro si sviluppa nativamente in ambiente Windows 11 x86-64, eliminando qualsiasi livello di traduzione o virtualizzazione. La viewport in 3ds Max sfrutta direttamente l'accelerazione hardware DirectX 12 nativa della GPU NVIDIA RTX 5060, garantendo una fluidità perfetta anche con scene ad altissima densità poligonale e l'attivazione di ombre morbide e occlusione ambientale in tempo reale. Per il rendering in V-Ray GPU, la scheda RTX 5060 Blackwell da 105 W abilita l'intera pipeline CUDA e OptiX. Nel benchmark ufficiale V-Ray 6 GPU CUDA, l'Asus TUF configurato con Ryzen AI 7 350 totalizza un punteggio di 581.80 vpaths. L'utente beneficia inoltre del Ray Reconstruction NVIDIA DLSS 4 per accelerare il denoising dell'immagine nella viewport interattiva durante la modellazione, riducendo i tempi di visualizzazione a pochi secondi rispetto alle ore richieste dall'emulazione della sola CPU su Mac.
Analisi dell'efficienza energetica, autonomia della batteria e peso
Il bilancio tra prestazioni pure e mobilità fisica definisce la reale usabilità sul campo di una workstation portatile da 14 pollici, e sotto questo profilo le due piattaforme adottano filosofie progettuali radicalmente diverse. L'Asus TUF A14 FA401KM adotta una batteria a 4 celle agli ioni di litio con una capacità complessiva di 73 WHrs. L'autonomia del dispositivo è fortemente influenzata dallo scenario d'uso e dalle modalità di gestione energetica selezionate tramite i profili software del produttore. Impostando la macchina in modalità Eco, disattivando fisicamente la GPU NVIDIA tramite il MUX Switch per utilizzare esclusivamente l'iGPU Radeon 860M, forzando il display a 60 Hz e riducendo la luminosità al 60 per cento, pari a circa 200 nits, il consumo energetico della piattaforma si stabilizza intorno agli 8-9 W, consentendo di raggiungere un'autonomia reale di circa 8-9 ore di lavoro continuativo. Tuttavia, l'autonomia è sensibile all'ottimizzazione del software di sistema: bug nei driver grafici o aggiornamenti del BIOS non ottimizzati possono causare il risveglio involontario della GPU dedicata in background, aumentando il consumo minimo e dimezzando l'autonomia a sole 4-5 ore anche per compiti basilari. Con la GPU RTX 5060 attiva a pieno regime fino a 105 W e la CPU operante in boost, il consumo complessivo della piattaforma supera i 135 W in modalità Manuale e la batteria si scarica completamente in circa 1,5-2 ore. Il dispositivo supporta la ricarica rapida tramite l'alimentatore proprietario da 200 W, ripristinando il 50 per cento della capacità in 30 minuti.
L'integrazione verticale di Apple Silicon e il processo produttivo a 3 nm consentono al MacBook Pro 14 pollici di registrare parametri di efficienza energetica notevolmente superiori rispetto alle architetture x86 mobili. Dotato di una batteria da 72.4 Wh, il MacBook Pro 14 pollici con chip M5 base garantisce un'autonomia dichiarata fino a 24 ore di riproduzione video in streaming continuo su Safari a 1080p con luminosità impostata a 8 clic dal minimo, e fino a 16 ore di navigazione web wireless. Nell'utilizzo reale d'ufficio o di navigazione con decine di tab aperte, il consumo energetico medio del chip M5 non supera i 3-4 W, consentendo all'utente di affrontare sessioni lavorative complete di oltre 12-14 ore senza mostrare segni di decadimento delle prestazioni o surriscaldamento. Anche sotto carichi di lavoro pesanti eseguiti in modalità nativa, l'autonomia si mantiene elevata, consentendo di completare flussi creativi come l'editing video o la compilazione di codice per oltre 6-8 ore lontano dalla presa di corrente.
Entrambi i dispositivi sono progettati per garantire la massima portabilità, ma presentano scelte costruttive e materiali differenti. L'Asus TUF Gaming A14 FA401KM ha un peso di 1.46 kg, con un telaio certificato secondo lo standard di resistenza militare MIL-STD-810H, realizzato prevalentemente in materiale plastico ad alta resistenza, con l'esclusione del coperchio superiore del display e del pannello posteriore in alluminio. Lo spessore varia da un minimo di 1.69 cm a un massimo di 1.99 cm, con ingombri complessivi pari a 31.1 x 22.7 cm. L'Apple MacBook Pro 14 pollici M5 registra un peso leggermente superiore, pari a 1.55 kg, con un telaio interamente fresato in lega di alluminio unibody che garantisce un'eccellente rigidità torsionale. Presenta uno spessore uniforme estremamente contenuto di soli 1.55 cm, con dimensioni di pianta pari a 31.26 x 22.12 cm.
L'analisi comparativa evidenzia in modo inequivocabile come la scelta tra le due piattaforme non si riduca a un mero confronto di potenza bruta, ma dipenda in modo diretto dalla natura del flusso di lavoro professionale dell'utente. La piattaforma Asus TUF Gaming A14 FA401KM offre una workstation nativa Windows x86 altamente performante ed estremamente economica rispetto alle soluzioni Apple. La presenza della GPU NVIDIA GeForce RTX 5060 Blackwell da 105 W con supporto nativo CUDA e OptiX rappresenta l'unico canale praticabile per i professionisti che necessitano di utilizzare Autodesk 3ds Max e Chaos V-Ray GPU in mobilità. L'assenza di layer di traduzione e la compatibilità diretta con DirectX 12 garantiscono la massima stabilità operativa, l'eliminazione dei lag nella viewport e tempi di rendering drasticamente ridotti. I principali compromessi di questa macchina risiedono in uno schermo IPS che manca di contrasto reale rispetto ai moderni standard OLED o Mini-LED, in un limite insuperabile di 16 GB di RAM non espandibile per la versione FA401KM, e in un'autonomia che, pur soddisfacente per compiti d'ufficio, decade rapidamente sotto carichi di calcolo pesanti. Al contrario, il MacBook Pro 14 pollici con chip Apple Silicon M5 si configura come il punto di riferimento assoluto per i creatori di contenuti digitali nativi macOS, come video editor, programmatori, audio creator e sviluppatori di modelli AI locali, che richiedono la massima potenza di elaborazione CPU sul mercato, velocità di archiviazione SSD superiori ai 13 GB/s, schermi Liquid Retina XDR Mini-LED di livello cinematografico e un'autonomia che consente di lavorare per un'intera giornata senza ricarica. Tuttavia, l'utilizzo di questa macchina per l'esecuzione di 3ds Max e Chaos V-Ray attraverso la virtualizzazione di Parallels Desktop introduce limitazioni gravissime: l'overhead di emulazione x86-64, l'assenza di supporto DirectX 12 che si traduce in viewport lag costanti, e l'impossibilità totale di utilizzare l'accelerazione GPU CUDA per il rendering ne compromettono l'usabilità, rendendo l'esperienza lenta, instabile e del tutto inadatta a contesti di produzione industriale.
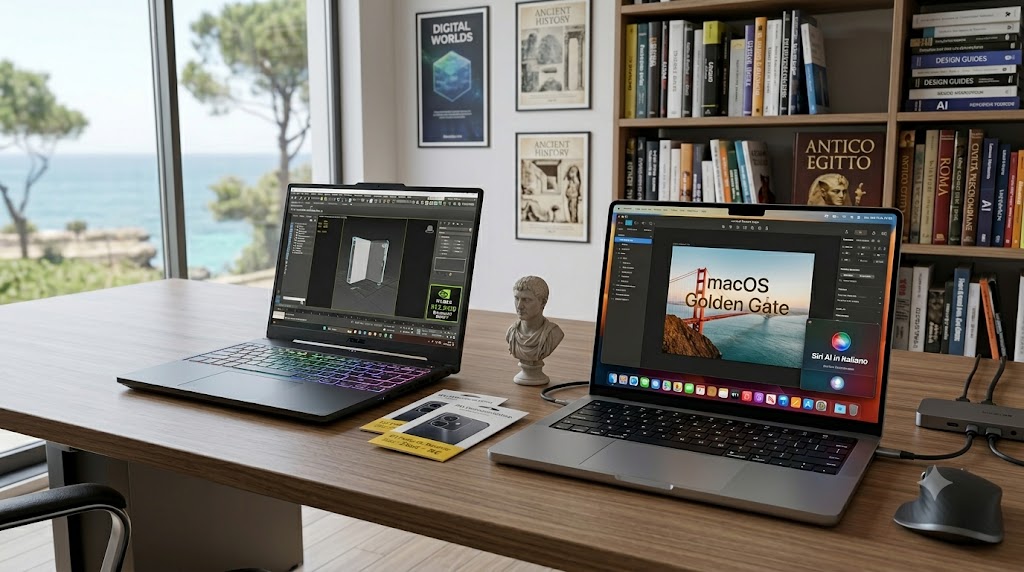
Apple MacBook Pro M5 supera nei benchmark Asus TUF Gaming A14, ma è un disastro con 3DS Max e V-Ray
OFFERTA 🛒Asus TUF Ryzen AI 350 1429 €  |
| OFFERTA 🛒Apple Macbook Pro M5 1752 € |
Bonus Video
L'evoluzione tecnologica delle workstation mobili da 14 pollici ha aperto la strada a prestazioni di livello desktop in formati estremamente portatili. Questa analisi tecnica mette a confronto l'Asus TUF Gaming A14 FA401KM, una piattaforma nativa Windows x86 dotata di GPU dedicata NVIDIA Blackwell, e l'architettura proprietaria Apple Silicon M5 (nelle sue declinazioni base, Pro e Max) operante in ambiente macOS nativo e virtualizzato tramite Parallels Desktop. La valutazione analizza le architetture dei processori, i benchmark sintetici, le velocità di archiviazione e connettività, le tecnologie dei display, le prestazioni nei carichi di lavoro professionali tridimensionali come Autodesk 3ds Max e Chaos V-Ray, l'efficienza energetica e la portabilità complessiva dei sistemi.
Analisi dei processori e delle architetture core
L'Asus TUF Gaming A14 FA401KM si basa sul microprocessore AMD Ryzen AI 7 350, appartenente alla famiglia di APU "Krackan Point" prodotta con il processo tecnologico FinFET a 4 nonomètri di TSMC. Questa architettura presenta un design ibrido a 8 core fisici e 16 thread grazie alla tecnologia Simultaneous Multithreading (SMT). La ripartizione interna prevede 4 core prestazionali Zen 5 in grado di raggiungere una frequenza massima di boost pari a 5,0 GHz, e 4 core densi Zen 5c ottimizzati per l'efficienza energetica, operanti con un clock massimo di 3,5 GHz. Il chip dispone di 16 MB di cache L3 condivisa e 8 MB di cache L2. Il Thermal Design Power (TDP) di base è fissato a 28W, ma può essere configurato dinamicamente dai produttori (cTDP) in un intervallo compreso tra 15W e 54W a seconda del profilo termico del notebook. Ad affiancare la CPU vi è una NPU AMD XDNA 2 integrata capace di erogare fino a 50 TOPS di potenza di calcolo dedicata ai modelli di intelligenza artificiale locali (fino a 66 TOPS combinati di piattaforma).
L'architettura proprietaria Apple Silicon M5 rappresenta un salto generazionale basato sul processo produttivo a 3 nonomètri di TSMC. Il chip M5 di base integra una CPU a 10 core complessivi, suddivisi in 4 "super core" prestazionali e 6 core ad alta efficienza energetica. I super core beneficiano di una riprogettazione del front-end, di una nuova gerarchia di cache e di un'unità di branch prediction ottimizzata per massimizzare le prestazioni single-thread. Salendo nella gamma, il chip M5 Pro adotta la Fusion Architecture (accoppiando due die fisici tramite interconnessioni ad altissima velocità) per offrire configurazioni fino a 18 core CPU (6 super core e 12 performance core). Il chip top di gamma M5 Max mantiene la medesima struttura a 18 core ma raddoppia le risorse grafiche e la larghezza di banda del bus di memoria unificata.
Una delle differenze architetturali più rilevanti risiede nel sottosistema di memoria. L'Asus TUF Gaming A14 FA401KM è limitato da una memoria LPDDR5X saldata sulla scheda madre operante a 7500 MHz, configurata in dual-channel con una capacità massima non aggiornabile di 16 GB. L'architettura Apple M5 si affida a memorie unificate LPDDR5X a 9600 MT/s integrate direttamente nel package del SoC. Questa memoria è condivisa dinamicamente tra CPU, GPU e Neural Engine grazie al sistema di allocazione unificata.
La larghezza di banda passante teorica della memoria può essere calcolata tramite l'equazione:
Larghezza di banda (GB/s) = (Frequenza DRAM × Ampiezza Bus × Numero di Canali) / 8
Applicando la formula alle diverse configurazioni hardware analizzate, si ottengono i seguenti valori di targa:
| Piattaforma | Larghezza di banda (GB/s) |
| Asus TUF (LPDDR5X-7500, Dual-Channel 128-bit) | 240,0 |
| Apple M5 Base (LPDDR5X-9600, Dual-Channel 128-bit) | 307,2 |
| Apple M5 Pro (LPDDR5X-9600, Quad-Channel 256-bit) | 1.228,8 |
| Apple M5 Max (LPDDR5X-9600, Octa-Channel 512-bit) | 4.915,2 |
Il vantaggio computazionale di Apple Silicon in termini di throughput di memoria è evidente, con M5 Max che offre una larghezza di banda oltre cinque volte superiore rispetto alla memoria saldata dell'Asus TUF, un fattore che si rivela determinante nell'elaborazione di dataset di grandi dimensioni e nell'inferenza di modelli linguistici locali (LLM).
| Caratteristica Architetturale | AMD Ryzen AI 7 350 (Asus TUF) | Apple M5 (Base) | Apple M5 Pro | Apple M5 Max |
| Processo Produttivo | TSMC 4nonomètri FinFET | TSMC 3nonomètri (Seconde Gen) | TSMC 3nonomètri (Fusion Die) | TSMC 3nonomètri (Fusion Die) |
| Configurazione Core (CPU) | 4x Zen 5 + 4x Zen 5c | 4 Super Core + 6 Efficiency | 6 Super Core + 12 Performance | 6 Super Core + 12 Performance |
| Thread Totali | 16 (SMT Attivo) | 10 (Single-Threaded Cores) | 18 (Single-Threaded Cores) | 18 (Single-Threaded Cores) |
| Frequenza di Clock | Da 2,0 GHz a 5,0 GHz | Fino a 4,6 GHz | Fino a 4,6 GHz | Fino a 4,6 GHz |
| Cache Integrata | 16MB L3 + 8MB L2 | Struttura proprietaria | Struttura proprietaria | Struttura proprietaria |
| Tecnologia di Memoria | LPDDR5X-7500 (Saldata) | LPDDR5X-9600 (SoC unificata) | LPDDR5X-9600 (SoC unificata) | LPDDR5X-9600 (SoC unificata) |
| Capacità Massima RAM | 16 GB | 32 GB | 64 GB | 128 GB |
| Canali e Ampiezza Bus | Dual-Channel (128-bit) | Dual-Channel (128-bit) | Quad-Channel (256-bit) | Octa-Channel (512-bit) |
| Potenza di Calcolo NPU | 50 TOPS (XDNA 2) | 16-Core Neural Engine | 16-Core Neural Engine | 16-Core (Banda Elevata) |
Benchmark di elaborazione con Geekbench 6.0 e analisi della GPU
I test comparativi eseguiti tramite la suite software Geekbench 6.0 evidenziano un divario prestazionale netto sia sul calcolo generico della CPU sia sul versante della grafica computazionale.
Prestazioni della CPU (Geekbench 6.0)
Il processore AMD Ryzen AI 7 350 installato sull'Asus TUF Gaming A14 FA401KM registra punteggi sintetici medi di circa 2.677 punti nel test Single-Core e 11.742 punti nel test Multi-Core. Sebbene queste metriche collochino la piattaforma x86 di AMD in una fascia competitiva rispetto alle generazioni precedenti (superando l'architettura Intel Lunar Lake Core Ultra 7 258V), l'efficienza d'istruzione per ciclo d'orologio (IPC) di Apple Silicon si rivela superiore.
Il chip Apple M5 di base, infatti, mette a referto un punteggio di 4.263 punti in Single-Core e 17.862 punti in Multi-Core. In ambito Single-Core, M5 stacca il Ryzen AI 7 350 del 59%, facendo registrare il punteggio a thread singolo più alto mai rilevato nel database di Geekbench 6.0 per processori consumer di questa categoria. In ambito Multi-Core, l'incremento prestazionale a favore di Apple si attesta sul 52%, a dimostrazione della bontà del design a 10 core complessivi.
L'estensione della gamma verso i chip a elevato numero di core evidenzia la scalabilità della Fusion Architecture: l'Apple M5 Max, configurato con una CPU a 18 core, raggiunge un punteggio multi-thread straordinario di 29.233 punti, superando del 148% la CPU dell'Asus TUF e battendo soluzioni desktop multithread ad alte prestazioni.
Prestazioni grafiche (GPU) e architettura Blackwell
L'Asus TUF Gaming A14 FA401KM si affida alla scheda grafica dedicata di nuova generazione NVIDIA GeForce RTX 5060 Laptop. Questa GPU si basa sull'architettura Blackwell (chip GB206 a 5 nonomètri di TSMC) ed è dotata di 3328 core CUDA, 104 Tensor core di quinta generazione e 26 core Ray Tracing di quarta generazione. La scheda dispone di 8 GB di memoria VRAM di tipo GDDR7 dedicata operante su un bus di memoria a 128 bit, garantendo una larghezza di banda pari a 384 GB/s. Sulla piattaforma TUF, la GPU è configurata per funzionare a una frequenza massima di 1737 MHz con un TGP di 105W (suddivisi in 90W stabili e 15W allocati dinamicamente tramite NVIDIA Dynamic Boost).
Nel benchmark di calcolo grafico Geekbench 6.0 OpenCL, la RTX 5060 Laptop fa registrare punteggi compresi tra 102.564 e 109.431 punti in base al sistema ospitante e alla dissipazione termica disponibile.
La GPU integrata da 10 core dell'Apple M5 base registra un punteggio nel benchmark grafico proprietario Metal di circa 76.727 punti. Sebbene l'iGPU di Apple mostri un'efficienza straordinaria in rapporto al consumo energetico, non può competere con la potenza bruta e i canali di calcolo parallelo della RTX 5060 dedicata a pieno voltaggio.
Tuttavia, salendo alle soluzioni di fascia alta, Apple colma il divario grazie al raddoppio hardware dei core grafici. La GPU a 40 core integrata nell'Apple M5 Max esegue il test Metal totalizzando punteggi compresi tra 218.772 e 232.718 punti. Questa configurazione, supportata da un'architettura di caching dinamico di seconda generazione e mesh shading con accelerazione hardware, supera del 110% le capacità di elaborazione della RTX 5060 mobile nativa, pur mantenendo un consumo energetico complessivo del sistema decisamente più basso.
| Metriche di Benchmark (Geekbench 6.0) | Asus TUF (Ryzen AI 7 350 + RTX 5060) | Apple MacBook Pro 14" (M5 Base) | Apple MacBook Pro 14" (M5 Max) |
| CPU Single-Core (Punti) | ~2.677 | ~4.263 | ~4.268 |
| CPU Multi-Core (Punti) | ~11.742 | ~17.862 | ~29.233 |
| GPU Compute - OpenCL (Punti) | ~105.000 (NVIDIA Dedicated) | Non Rilevante | ~132.000 (Apple Silicon) |
| GPU Compute - Metal (Punti) | Non Supportato | ~76.727 (Apple Integrated) | ~225.000 (Apple Integrated) |
| PassMark G3D Mark (Punti) | ~16.798 (RTX 5060) | Non Rilevante | Non Rilevante |
Archiviazione SSD e prestazioni delle interfacce USB e Thunderbolt
La reattività globale del sistema e la rapidità nel trasferimento di file pesanti (come librerie di texture 3D o progetti CAD) sono determinate dalle prestazioni dei canali di memorizzazione e dalle interfacce di espansione fisiche.
Velocità e canali dell'archiviazione SSD
L'Asus TUF Gaming A14 FA401KM adotta una configurazione di archiviazione basata su un'unità a stato solido M.2 NVMe PCIe Gen 4x4 da 1TB. Nei benchmark di lettura e scrittura sequenziale eseguiti tramite PassMark o AS SSD, l'unità preinstallata di classe Micron registra velocità tipiche di circa 2.168 MB/s in lettura sequenziale e 1.725 MB/s in scrittura sequenziale. Gli utenti che decidono di aggiornare l'unità con SSD di fascia alta (come il Kingston NV3 PCIe 4.0) possono raggiungere velocità di targa fino a 6.000 MB/s in lettura e 5.000 MB/s in scrittura.
Tuttavia, le prestazioni reali di copia di file ad alta capacità si attestano su valori più contenuti: nel test standardizzato di trasferimento di un pacchetto di dati da 25 GB, la piattaforma Asus TUF registra una velocità media sostenuta di scrittura di soli 1.520,83 MB/s.
Un limite architetturale importante dell'Asus TUF risiede nello schema di cablaggio dei canali PCIe sulla scheda madre. Sebbene il laptop offra due slot fisici M.2 2280 NVMe per l'espansione della memoria (fino a 4TB totali), le limitazioni della piattaforma del processore AMD forzano il secondo slot a operare esclusivamente a velocità ridotta PCIe 4.0 x2. Di conseguenza, qualsiasi SSD ad alte prestazioni installato nel secondo alloggiamento vedrà dimezzata la sua larghezza di banda potenziale.
L'ecosistema Apple Silicon M5 implementa un'architettura di archiviazione proprietaria ad altissimo rendimento. Il controller dell'SSD non è integrato nell'unità di memorizzazione stessa, ma è inserito direttamente sul silicio del SoC M5, consentendo a macOS di gestire la memoria NAND con una latenza ridotta e una conoscenza diretta del file system.
- Apple M5 Base: Utilizza una connessione PCIe Gen 5.0 x2 che consente di raggiungere velocità sequenziali nel test Blackmagic Disk Speed di circa 6.323 MB/s in lettura e 6.068 MB/s in scrittura, segnando un incremento prestazionale in lettura fino al 211% rispetto alla passata generazione M4.
- Apple M5 Pro e Max: Sfruttano un'interfaccia PCIe Gen 5.0 x4 e una maggiore parallelizzazione dei chip NAND flash (soprattutto nei tagli da 4TB o superiori). I test eseguiti sul campo rivelano velocità di lettura sostenuta pari a 13,6 GB/s e velocità di scrittura di ben 17,8 GB/s. Moduli ad altissima capacità da 8TB beneficiano di un numero ancora maggiore di canali e planes NAND paralleli, raggiungendo una larghezza di banda di trasferimento record vicina ai 22 GB/s.
Velocità e standard delle porte di connettività
La dotazione di porte dell'Asus TUF Gaming A14 FA401KM offre un mix di interfacce veloci e legacy che richiedono attenzione da parte dell'utente per evitare colli di bottiglia:
- Una porta Type-C USB 4 operante a 40 Gbps, che supporta l'uscita video DisplayPort e il protocollo Power Delivery.
- Una porta Type-C USB 3.2 Gen 2 limitata a 10 Gbps, che supporta DisplayPort e G-Sync.
- Due porte Type-A USB 3.2 Gen 2 operanti a 10 Gbps.
- Un'uscita video HDMI 2.1 FRL e un lettore di schede MicroSD UHS-II in grado di raggiungere una velocità teorica di 312 MB/s.
La discrepanza tra le due porte Type-C è notevole: l'utilizzo di una docking station o di un box SSD esterno ad alta velocità fornirà prestazioni ottimali solo se collegato alla specifica porta USB4, mentre la porta USB 3.2 Gen 2 ne ridurrà le prestazioni a un quarto della velocità teorica.
Il MacBook Pro 14" con chip M5 di base offre tre porte Thunderbolt 4 (Type-C). Ciascuna porta fornisce una larghezza di banda simmetrica di 40 Gbps per dati e video (DisplayPort 1.4), garantendo l'assenza di asimmetrie funzionali. Inoltre, sono presenti una porta HDMI 2.1, uno slot per schede SDXC e un connettore MagSafe 3 per la ricarica rapida.
Sulle configurazioni con chip M5 Pro e M5 Max, Apple integra controller fisici Thunderbolt dedicati a livello di chip per ciascuna singola porta, aggiornando le interfacce allo standard Thunderbolt 5. Thunderbolt 5 offre:
- Fino a 80 Gbps di larghezza di banda bidirezionale simmetrica per trasferimenti di dati standard.
- Fino a 120 Gbps di throughput grazie alla tecnologia Bandwidth Boost per scenari video intensivi, consentendo di gestire simultaneamente fino a tre schermi esterni ad alta risoluzione a 6K a 60Hz attraverso un singolo cavo collegato a una docking station Thunderbolt 5.
| Parametro Hardware | Asus TUF A14 FA401KM | MacBook Pro 14" M5 Base | MacBook Pro 14" M5 Max |
| Interfaccia SSD Interna | PCIe Gen 4x4 (Slot 1) / Gen 4x2 (Slot 2) | PCIe Gen 5.0 x2 | PCIe Gen 5.0 x4 |
| Velocità Lettura Sequenziale | ~2.168 MB/s (Micron standard) | ~6.323 MB/s (Blackmagic) | ~13.600 MB/s (Sostenuta) |
| Velocità Scrittura Sequenziale | ~1.725 MB/s (Micron standard) | ~6.068 MB/s (Blackmagic) | ~17.800 MB/s (Sostenuta) |
| Porte ad Alta Velocità | 1x USB 4 (40 Gbps) | 3x Thunderbolt 4 (40 Gbps) | 3x Thunderbolt 5 (80/120 Gbps) |
| Porte Standard/Legacy | 1x USB-C (10 Gbps) + 2x USB-A (10 Gbps) | Nessuna (Adattatori Richiesti) | Nessuna (Adattatori Richiesti) |
| Uscita Video Integrata | HDMI 2.1 FRL | HDMI 2.1 | HDMI 2.1 (Supporto 8K) |
| Lettore di Schede Flash | MicroSD UHS-II (312 MB/s) | SDXC (Alta Velocità) | SDXC (Alta Velocità) |
Risoluzione del display, nitidezza e fedeltà cromatica
La resa visiva e la precisione millimetrica nella riproduzione spaziale delle geometrie e dei colori sono elementi fondamentali per i professionisti della grafica computazionale.
L'Asus TUF Gaming A14 adotta un pannello IPS opaco (anti-glare) da 14 pollici in formato 16:10 con risoluzione 2.5K WQXGA (2560x1600 pixel). Lo schermo offre una frequenza di aggiornamento di 165Hz, un tempo di risposta di 3ms e la tecnologia di sincronizzazione dinamica G-Sync, coadiuvata da un MUX Switch fisico e NVIDIA Advanced Optimus per escludere la scheda video integrata e ridurre la latenza. La copertura cromatica è limitata al 100% dello spazio sRGB, mentre la luminosità massima dichiarata è di 400 nits. I test di riflettanza indicano un valore di 50.5 GU, collocando il pannello in una classe a media riflettanza.
Sebbene la nitidezza e la reattività siano soddisfacenti per il gaming e compiti generici, la tecnologia IPS mostra carenze evidenti in contesti di editing professionale: il rapporto di contrasto nativo non supera i 1000:1, determinando neri che tendono al grigio scuro e una dinamica HDR praticamente assente a causa della retroilluminazione globale.
Il MacBook Pro 14.2" monta un display con tecnologia Liquid Retina XDR, basato su una matrice Mini-LED proprietaria che consente il controllo della luminosità a livello di zone microscopiche. La risoluzione nativa è di 3024x1964 pixel con una densità di 254 pixel per pollice (ppi). Le specifiche tecniche superano in modo netto le capacità del pannello IPS dell'Asus TUF:
- Luminosità: Offre fino a 1000 nits di luminosità sustained a schermo intero e ben 1600 nits di picco durante la riproduzione di contenuti HDR. In contesti SDR all'aperto, la luminosità massima raggiunge i 1000 nits, garantendo una leggibilità ottimale sotto la luce solare diretta.
- Rapporto di Contrasto: Raggiunge un valore reale di 1.000.000:1, assicurando neri assoluti nelle aree d'ombra grazie allo spegnimento completo dei Mini-LED.
- Spazio Colore: Copre interamente lo spettro cromatico ad ampia gamma DCI-P3 con una profondità di colore a 10 bit (1 miliardo di colori) e implementa la tecnologia True Tone insieme a ProMotion (refresh rate adattivo fino a 120Hz). Per gli ambienti di lavoro caratterizzati da forti sorgenti di luce artificiale o naturale, è disponibile in opzione un vetro con trattamento a nano-texture antiriflesso.
| Caratteristica del Display | Asus TUF A14 FA401KM | MacBook Pro 14" M5 |
| Dimensioni e Formato | 14.0 pollici (16:10) | 14.2 pollici (16:10, angoli arrotondati) |
| Risoluzione Nativa | 2560 x 1600 pixel (WQXGA) | 3024 x 1964 pixel |
| Densità di Pixel (ppi) | 215 ppi | 254 ppi |
| Tecnologia del Pannello | IPS-Level (Retroilluminazione Globale) | Mini-LED (Liquid Retina XDR) |
| Trattamento Superficie | Opaco Anti-Glare (Riflettanza 50.5 GU) | Lucido (Opzione Vetro con Nano-Texture) |
| Rapporto di Contrasto | ~1000:1 (Nero IPS) | 1.000.000:1 (Nero Assoluto) |
| Luminosità Massima (SDR) | 400 nits | 1000 nits (Outdoor sostenuta) |
| Luminosità Massima (HDR) | Non Rilevante (Scarsa resa HDR) | 1600 nits (Picco dinamico) |
| Profondità e Spazio Colore | 8-bit, sRGB: 100.00% | 10-bit (P3 Wide Color), 1 miliardo di colori |
| Frequenza di Aggiornamento | 165Hz (Fissa o G-Sync) | 120Hz (ProMotion adattiva o frequenze fisse) |
Prestazioni in virtualizzazione: 3ds Max e Chaos V-Ray sotto Parallels su Mac
La valutazione dell'efficienza dei flussi di lavoro tridimensionali evidenzia l'insorgere di colli di bottiglia e incompatibilità hardware significative quando si tenta di eseguire suite di modellazione e rendering professionali in ambiente macOS virtualizzato.
L'incompatibilità architetturale di Autodesk 3ds Max
Autodesk 3ds Max è un'applicazione software sviluppata storicamente in modo esclusivo per l'ambiente operativo Microsoft Windows x86-64. Non esiste alcuna versione compilata nativamente per macOS.
Quando si esegue il programma su un MacBook Pro con processore Apple Silicon M5, è necessario utilizzare Parallels Desktop per creare una macchina virtuale basata sulla versione ARM64 di Windows 11. Poichè 3ds Max non dispone di un codice sorgente nativo ARM, il sistema operativo Windows virtualizzato deve applicare un layer di emulazione in tempo reale per tradurre le istruzioni x86-64 in comandi compatibili con l'architettura dei core ARM di Apple. Questa doppia transizione (virtualizzazione dell'Hypervisor unita all'emulazione binaria) comporta un degrado prestazionale diretto della CPU stimato tra il 15% e il 30% rispetto alle performance native del processore in ambiente macOS nativo.
Limitazioni grafiche e viewport lag in Parallels
La viewport di 3ds Max (il motore grafico integrato per la manipolazione e l'anteprima delle mesh 3D) si basa sull'API grafica Microsoft DirectX. L'architettura hardware di Apple Silicon non supporta nativamente le librerie DirectX, affidandosi esclusivamente alle proprie API proprietarie Metal.
La scheda video virtuale emulata da Parallels Desktop su Apple Silicon introduce una limitazione critica: supporta al massimo le librerie DirectX 11.1 e OpenGL 4.1. Non vi è alcun supporto per le API di nuova generazione DirectX 12 o Vulkan.
Di conseguenza, 3ds Max è costretto a rinunciare alle ottimizzazioni del driver grafico avanzato Nitrous (che richiede DirectX 12). Nella pratica professionale, la manipolazione di scene moderatamente complesse (contenenti geometrie ad alto numero di poligoni, texture ad alta risoluzione o ombreggiature in tempo reale) risulta estremamente problematica: si verificano vistosi ritardi di redraw della viewport, stutters costanti durante le operazioni di rotazione o zoom della camera e frequenti crash dovuti a incompatibilità dei driver grafici virtualizzati. Autodesk dichiara ufficialmente 3ds Max come configurazione non supportata in ambienti virtuali, declinando qualsiasi supporto tecnico per bug generati sotto Parallels.
La pipeline interrotta di Chaos V-Ray GPU
Chaos V-Ray rappresenta uno dei motori di rendering professionali più diffusi sul mercato. La sua pipeline di rendering ad alte prestazioni, V-Ray GPU, è interamente ingegnerizzata per sfruttare le API proprietarie NVIDIA CUDA e NVIDIA OptiX.
Poichè Apple Silicon utilizza una GPU integrata proprietaria priva di hardware NVIDIA, e Parallels Desktop esegue la virtualizzazione della GPU traducendo i comandi in chiamate Metal su macOS (senza consentire un pass-through hardware diretto dei registri fisici della GPU), la macchina virtuale Windows non rileva alcun dispositivo grafico compatibile con CUDA. Di conseguenza, la modalità di calcolo V-Ray GPU risulta totalmente inagibile e disattivata su MacBook Pro operante sotto Parallels.
L'utente è obbligato a ripiegare esclusivamente sulla modalità di rendering V-Ray CPU. Tuttavia, l'elaborazione tramite processore virtualizzato sconta pesanti colli di bottiglia logici:
- La licenza Standard di Parallels Desktop limita l'allocazione delle risorse per la macchina virtuale a un massimo di 4 core vCPU e 8 GB di RAM virtuale, una quantità del tutto insufficiente per caricare geometrie complesse e texture 3D.
- Per sbloccare fino a 18 core vCPU e 62 GB di RAM è necessario sottoscrivere un abbonamento annuale ricorrente alla licenza Parallels Pro.
- Anche disponendo della licenza Pro, l'emulazione dei set di istruzioni vettoriali avanzati (come AVX-512 o AVX2, fondamentali per la velocità dei calcoli di ray-tracing di V-Ray) risulta rallentata rispetto all'esecuzione nativa su hardware x86. Il rendering interattivo si rivela scattoso, privo di reattività in tempo reale e inadatto a flussi di lavoro industriali, richiedendo tempi di calcolo dalle 2 alle 10 volte superiori rispetto al rendering GPU.
Confronto con le prestazioni native su Asus TUF Gaming A14 FA401KM
Sulla piattaforma Asus TUF Gaming A14 FA401KM, l'intero flusso di lavoro si sviluppa nativamente in ambiente Windows 11 x86-64, eliminando qualsiasi livello di traduzione o virtualizzazione.
- Viewport in 3ds Max: Sfrutta direttamente l'accelerazione hardware DirectX 12 nativa della GPU NVIDIA RTX 5060, garantendo una fluidità perfetta anche con scene ad altissima densità poligonale e l'attivazione di ombre morbide e occlusione ambientale in tempo reale.
- Rendering in V-Ray GPU: La scheda RTX 5060 Blackwell da 105W abilita l'intera pipeline CUDA e OptiX. Nel benchmark ufficiale V-Ray 6 GPU CUDA, l'Asus TUF configurato con Ryzen AI 7 350 totalizza un punteggio di 581.80 vpaths. L'utente beneficia inoltre del Ray Reconstruction (NVIDIA DLSS 4) per accelerare il denoising dell'immagine nella viewport interattiva durante la modellazione, riducendo i tempi di visualizzazione a pochi secondi rispetto alle ore richieste dall'emulazione della sola CPU su Mac.
Analisi dell'efficienza energetica, autonomia della batteria e peso
Il bilancio tra prestazioni pure e mobilità fisica definisce la reale usabilità sul campo di una workstation portatile da 14 pollici.
Comportamento energetico e autonomia dell'Asus TUF A14 FA401KM
L'Asus TUF A14 FA401KM adotta una batteria a 4 celle agli ioni di litio con una capacità complessiva di 73 WHrs. L'autonomia del dispositivo è fortemente influenzata dallo scenario d'uso e dalle modalità di gestione energetica selezionate tramite i profili software del produttore:
- Utilizzo Produttività Leggera (Web Browsing / Office): Impostando la macchina in modalità "Eco" (disattivando fisicamente la GPU NVIDIA tramite il MUX Switch per utilizzare esclusivamente l'iGPU Radeon 860M), forzando il display a 60Hz e riducendo la luminosità al 60% (circa 200 nits), il consumo energetico della piattaforma si stabilizza intorno agli 8W-9W, consentendo di raggiungere un'autonomia reale di circa 8-9 ore di lavoro continuativo. Tuttavia, l'autonomia è sensibile all'ottimizzazione del software di sistema: bug nei driver grafici o aggiornamenti del BIOS non ottimizzati possono causare il risveglio involontario della GPU dedicata in background, aumentando il consumo minimo e dimezzando l'autonomia a sole 4-5 ore anche per compiti basilari.
- Utilizzo ad Alto Carico (Rendering / Gaming): Con la GPU RTX 5060 attiva a pieno regime (fino a 105W) e la CPU operante in boost, il consumo complessivo della piattaforma supera i 135W complessivi in modalità Manuale. In questo scenario, la batteria si scarica completamente in circa 1,5 - 2 ore.
- Ricarica: Il dispositivo supporta la ricarica rapida tramite l'alimentatore proprietario da 200W, ripristinando il 50% della capacità in 30 minuti.
Comportamento energetico e autonomia di Apple MacBook Pro 14" M5
L'integrazione verticale di Apple Silicon e il processo produttivo a 3 nonomètri consentono al MacBook Pro 14" di registrare parametri di efficienza energetica notevolmente superiori rispetto alle architetture x86 mobili.
Dotato di una batteria da 72.4 Wh, il MacBook Pro 14" con chip M5 base garantisce un'autonomia dichiarata fino a 24 ore di riproduzione video in streaming continuo (Safari, 1080p, luminosità impostata a 8 clic dal minimo) e fino a 16 ore di navigazione web wireless.
Nell'utilizzo reale d'ufficio o di navigazione con decine di tab aperte, il consumo energetico medio del chip M5 non supera i 3W-4W, consentendo all'utente di affrontare sessioni lavorative complete di oltre 12-14 ore senza mostrare segni di decadimento delle prestazioni o surriscaldamento. Anche sotto carichi di lavoro pesanti eseguiti in modalità nativa, l'autonomia si mantiene elevata, consentendo di completare flussi creativi (come l'editing video o la compilazione di codice) per oltre 6-8 ore lontano dalla presa di corrente.
Peso e dimensioni fisiche
Entrambi i dispositivi sono progettati per garantire la massima portabilità, ma presentano scelte costruttive e materiali differenti:
- Asus TUF Gaming A14 FA401KM: Ha un peso di 1.46 kg. Il telaio, certificato secondo lo standard di resistenza militare MIL-STD-810H, è realizzato prevalentemente in materiale plastico ad alta resistenza, con l'esclusione del coperchio superiore del display e del pannello posteriore in alluminio. Lo spessore varia da un minimo di 1.69 cm a un massimo di 1.99 cm, con ingombri complessivi pari a 31.1 x 22.7 cm.
- Apple MacBook Pro 14" M5: Registra un peso leggermente superiore, pari a 1.55 kg. Il telaio è interamente fresato in lega di alluminio unibody, garantendo un'eccellente rigidità torsionale. Presenta uno spessore uniforme estremamente contenuto di soli 1.55 cm, con dimensioni di pianta pari a 31.26 x 22.12 cm.
In conclusione, la scelta tra l'Asus TUF Gaming A14 FA401KM e il MacBook Pro M5 si riduce alla natura del flusso lavorativo. La piattaforma nativa Windows x86 con GPU NVIDIA Blackwell è l'unica opzione percorribile per i professionisti che necessitano di stabilità e accelerazione hardware in suite come 3ds Max e V-Ray. Il sistema Apple Silicon, invece, si conferma il re incontrastato dell'efficienza energetica, della resa del display e della velocità di archiviazione per tutti quei creator digitali in grado di operare senza ostacoli all'interno dell'ecosistema macOS nativo. Tuttavia, l'utilizzo di questa macchina per l'esecuzione di 3ds Max e Chaos V-Ray attraverso la virtualizzazione di Parallels Desktop introduce limitazioni gravissime che ne compromettono l'usabilità in contesti di produzione industriale.
Architettura di emulazione x86-64 e impatto di Prism
La migrazione dei sistemi Macintosh verso l'architettura ARM64 ha interrotto la compatibilità nativa con Autodesk 3ds Max, escludendo l'uso di utilità storiche come Boot Camp, limitate ai vecchi sistemi con processori Intel. L'unica strada percorribile localmente è rappresentata dall'installazione della versione Windows 11 su ARM all'interno dell'ambiente virtuale Parallels Desktop.
Il superamento delle barriere computazionali AVX/AVX2
Nelle prime fasi evolutive dei chip Apple Silicon, l'esecuzione di 3ds Max e di motori di rendering ad alte prestazioni risultava parzialmente compromessa o del tutto inibita a causa dell'assenza di un supporto stabile per le istruzioni vettoriali Advanced Vector Extensions (AVX e AVX2), richieste tassativamente dai motori di calcolo moderni. La transizione verso Windows 11 (a partire dalla versione 24H2) ha introdotto l'emulatore Prism, un motore di traduzione Just-In-Time (JIT) che compila blocchi di istruzioni x86/x64 in istruzioni ARM64 ottimizzate, memorizzandole in cache per ridurre l'overhead nei lanci successivi. Prism ha sbloccato l'emulazione delle estensioni AVX e AVX2, consentendo finalmente l'avvio e il funzionamento di 3ds Max e delle suite Chaos V-Ray e Corona all'interno di macchine virtuali su Apple Silicon.
Il deficit matematico dell'emulazione vettoriale
Nonostante l'apertura alla compatibilità, la traduzione delle istruzioni AVX2 tramite Prism impone un severo costo prestazionale. L'architettura dei processori ARM presenta registri vettoriali NEON con una larghezza di banda pari a 128 bit, mentre le istruzioni AVX2 si basano su registri ampi 256 bit. Per eseguire un'istruzione AVX2, l'emulatore deve suddividere il calcolo in due cicli sequenziali da 128 bit. Questa scomposizione fisica implica che il codice compilato per AVX2 venga eseguito a circa i due terzi (66%) della velocità teorica rispetto a un'esecuzione nativa su hardware x86 ottimizzato. L'attivazione di tali funzionalità emulative all'interno di Parallels Desktop comporta rallentamenti avvertibili, motivo per cui la community ne sconsiglia l'abilitazione per applicazioni che non ne richiedano tassativamente l'uso.
Parametri di benchmark e allocazione risorse su M5 Pro e M5 Max
I processori Apple Silicon M5 introducono una revisione architetturale che elimina i tradizionali core ad alta efficienza a favore di un design composto esclusivamente da core "Performance" e core "Super". Questa struttura massimizza il throughput in scenari multi-thread, supportata da una larghezza di banda della memoria unificata che raggiunge i 614 GB/s sul chip M5 Max con GPU a 40 core. Tuttavia, l'efficacia del chip viene filtrata dalle restrizioni dell'hypervisor Parallels Desktop. La versione Standard di Parallels limita l'allocazione delle risorse a un massimo di 8 GB di memoria virtuale e 4 core CPU (vCPU), mentre la versione Pro consente di estendere i parametri fino a 62 GB di RAM e 18 vCPU. Inoltre, le attività di calcolo all'interno della macchina virtuale subiscono una penalizzazione prestazionale intrinseca del 15-30% a livello di CPU, accompagnata da una degradazione più marcata sul fronte della gestione delle chiamate Direct3D.
La tabella seguente mette a confronto le prestazioni sintetiche dei chip della famiglia M5 con le generazioni precedenti e con configurazioni x86 di riferimento per evidenziare il potenziale hardware teorico rispetto a quello effettivamente sfruttabile:
| Processore / Piattaforma | Configurazione Core CPU | Geekbench 6 Single-Core | Geekbench 6 Multi-Core | Cinebench 2026 CPU Multi | Larghezza di Banda Memoria |
| Apple M5 Max (Nativo) | 18 Core (12P + 6S) | 4.353 | 29.644 | 8.413 | ~614 GB/s |
| Apple M5 Pro (Nativo) | 18 Core (12P + 6S) | 4.319 | 28.964 | 9.581 | ~307 GB/s (Dato Stimato) |
| Apple M4 Max (Nativo) | 16 Core (12P + 4E) | 4.054 | 26.320 | 7.829 | ~546 GB/s |
| Apple M3 Ultra (Nativo) | 32 Core (24P + 8E) | 3.226 | 27.551 | 12.082 | ~819 GB/s |
| Intel Core Ultra 9 285K | 24 Core (8P + 16E) | 3.165 | 21.014 | — | Variabile (DDR5) |
| Ryzen 9 9950X3D | 16 Core / 32 Thread | 3.466 | 24.057 | — | Variabile (DDR5) |
| Alienware M18R2 (i9-14900HX) | 24 Core / 32 Thread | 490 (Cinebench) | 17.507 (GB6) | 8.048 | Variabile (DDR5) |
I dati indicano che, sebbene la potenza multi-thread dei chip M5 sia straordinaria in modalità nativa, l'overhead introdotto dalla virtualizzazione e dalla traduzione JIT di Prism riduce drasticamente l'efficienza della CPU, portando la velocità di esecuzione pratica al di sotto di macchine Windows native di fascia media.
Analisi di compatibilità con Chaos V-Ray 7 e versioni precedenti
Chaos V-Ray 7 per 3ds Max supporta formalmente le edizioni del software Autodesk dalla versione 2021 alla 2026. L'integrazione di questo motore di rendering in un ambiente virtualizzato su MacBook Pro M5 rivela tuttavia barriere strutturali che limitano drasticamente le modalità di calcolo disponibili.
La totale incompatibilità del rendering GPU (V-Ray GPU)
Il fulcro dei limiti di compatibilità risiede nella tecnologia del motore V-Ray GPU:
- Requisiti proprietari: V-Ray GPU richiede percorsi di esecuzione basati su NVIDIA CUDA o NVIDIA RTX, legati esclusivamente all'hardware del produttore di Santa Clara con compute capability minima pari a 5.2.
- Assenza di accelerazione in VM: Apple non integra GPU NVIDIA nei propri sistemi e l'hypervisor Parallels Desktop non dispone del passthrough hardware della GPU. Parallels emula una scheda video virtuale limitata alle specifiche DirectX 11.
- Blocco esecutivo: È impossibile avviare rendering GPU o avvalersi di strumenti di previsualizzazione in tempo reale come Chaos Vantage. I flussi di calcolo che prevedono l'uso combinato di processore e scheda video (Rendering Ibrido CUDA/RTX) non possono essere inizializzati.
Il rendering CPU come unica opzione operativa
L'unica modalità di calcolo accessibile in 3ds Max virtualizzato è il rendering basato esclusivamente sulla CPU (V-Ray CPU), che supporta le nuove funzioni di V-Ray 7 come Chaos Scatter 2.0 ed Enmesh. Per stabilire il limite prestazionale massimo esprimibile dai core di Apple Silicon in ambiente Chaos V-Ray, è possibile fare riferimento ai benchmark ufficiali ottenuti in ambiente nativo macOS (eseguiti tramite host compatibili come SketchUp, Maya o Cinema 4D, esenti dall'overhead di Parallels):
| Dispositivo Hardware | Configurazione Core CPU fisici | Numero di Benchmark Registrati | Punteggio Medio Registrato (vsamples) |
| Apple M4 Max | 16 Core / 16 Core Logici | 18 | 31.261 |
| Apple M4 Max | 14 Core / 14 Core Logici | 8 | 27.784 |
| Apple M4 Pro | 14 Core / 14 Core Logici | 23 | 24.915 |
| Apple M4 Pro | 12 Core / 12 Core Logici | 18 | 22.017 |
| Apple M4 | 10 Core / 10 Core Logici | 39 | 15.762 |
Quando questi valori teorici vengono tradotti in ambiente virtuale Parallels Desktop su MacBook Pro M5, il rendimento effettivo subisce il decremento prestazionale del 15-30% generato dall'hypervisor, sommato alle latenze descritte per l'emulazione delle istruzioni AVX2 tramite Prism. Ne consegue che, sebbene il rendering sia matematicamente accurato e stabile nei calcoli, l'efficienza complessiva rimane nettamente inferiore rispetto a soluzioni basate su PC dedicati dotati di hardware x86 e schede grafiche NVIDIA RTX.
Deostruzione tecnico-analitica delle testimonianze di fluidità della community
L'analisi dei forum specialistici e delle sezioni di Reddit evidenzia una marcata discrepanza di opinioni. Da un lato, testimonianze isolate, come quelle dell'utente Sinbew, descrivono sessioni operative con MacBook Pro M5 Pro in ambiente Windows on ARM capaci di gestire scene complesse da 38 milioni di poligoni a oltre 130 fotogrammi al secondo (FPS) all'interno del viewport Nitrous di 3ds Max. Dall'altro, utenti professionisti con esperienza pluriennale denunciano rallentamenti drammatici, instabilità cronica e crash sistematici nell'interazione con i file di produzione.
La spiegazione tecnica dell'elevato frame rate dichiarata nei viewport
La possibilità di raggiungere un frame rate superiore ai 130 FPS con decine di milioni di poligoni su una GPU virtualizzata in ambiente emulato risponde a precise logiche di ottimizzazione della scena e non a prestazioni di disegno brute del sistema di virtualizzazione:
- Uso estensivo di istanze e geometrie proxy: Il motore grafico di 3ds Max non calcola singolarmente ogni poligono se questo è generato come istanza o caricato tramite file V-Ray Proxy. Utilizzando la rappresentazione semplificata a scatola di delimitazione (Bounding Box), la scheda grafica emulata elabora solo pochi vettori di ingombro nel viewport Nitrous, riducendo drasticamente il numero di chiamate al disegno 3D (draw calls).
- Disattivazione del rendering progressivo: Disabilitando l'opzione "Improve Quality Progressively" all'interno delle impostazioni di Nitrous, si impedisce al viewport di eseguire continui passaggi di raffinamento dell'immagine, eliminando il blocco verticale dei 60 FPS e incrementando la fluidità visiva di navigazione.
- Conversione in Editable Mesh: La conversione degli oggetti poligonali complessi dallo stack dinamico "Editable Poly" a strutture statiche "Editable Mesh" riduce il footprint in memoria RAM e ottimizza i calcoli geometrici immediati all'interno della GPU virtuale.
Le problematiche riscontrate nell'uso professionale reale
La fluidità percepita durante la navigazione di scene ottimizzate svanisce quando l'utente passa alle fasi attive di modellazione e interazione geometrica. Gli utenti su Reddit evidenziano limiti severi legati alla natura stessa della virtualizzazione:
- Latenza di modifica e modificatori complessi: L'applicazione di modificatori pesanti (come Edit Poly su mesh dense) o l'esecuzione di operazioni vettoriali complesse determinano picchi di utilizzo della CPU virtualizzata al 100%, poichè i calcoli non vengono accelerati dalla GPU ma gestiti interamente dallo strato emulativo Prism. Ciò si traduce in micro-lag prolungati e ritardi di risposta nell'interfaccia utente.
- Incompatibilità dei driver grafici e crash: L'assenza di driver grafici certificati per l'hardware Apple Silicon all'interno di Windows 11 su ARM espone 3ds Max a crash frequenti durante l'importazione di file CAD o lo spostamento di geometrie complesse. Professionisti del calibro dell'utente MuchCattle confermano che l'uso di Parallels per applicativi 3D intensivi si rivela "un controsenso", portandoli a dismettere MacBook Pro carichi di memoria unificata a favore di workstation Windows fisse o portatili con schede dedicate.
Conclusioni e raccomandazioni operative
L'acquisto di un MacBook Pro M5 per l'utilizzo primario di Autodesk 3ds Max e Chaos V-Ray 7 tramite Parallels Desktop rappresenta una scelta strategica sconsigliata per contesti di produzione professionale, sebbene possa risultare una soluzione di ripiego accettabile per studenti o per attività di pura modellazione in mobilità. Le limitazioni imposte dall'emulazione Prism per le istruzioni AVX2 e l'assenza totale del supporto alle API NVIDIA CUDA riducono drasticamente l'efficienza di calcolo dell'hardware Apple.
La tabella finale sintetizza i diversi approcci operativi percorribili dai professionisti della computer grafica 3D che scelgono di integrare o mantenere dispositivi Apple nel proprio workflow:
| Parametro di Analisi | Parallels Desktop su MacBook M5 | Workstation Windows PC Dedicata | Integrazione MacBook M5 + Cloud GPU |
| Prestazioni Viewport (3ds Max) | Medie; soggette a rallentamenti su mesh non istanziate | Elevate; supporto DirectX 11/12 nativo e driver dedicati | Elevate; calcolo gestito su server remoto ad alte prestazioni |
| Rendering V-Ray 7 (Velocità) | Bassa; limitata alla sola CPU con penalità del 15-30% | Massima; accelerazione hardware GPU CUDA e OptiX | Elevata/Massima; rendering scalabile su nodi GPU remoti |
| Stabilità Operativa | Bassa; frequenti crash di driver grafici e conflitti emulativi | Massima; supporto ufficiale e certificazione Autodesk | Massima; esecuzione in ambiente nativo sul server cloud |
| Portabilità ed Ergonomia | Eccellenti; assenza di rumore e consumi ridotti a batteria | Ridotte; elevata rumorosità, peso consistente e autonomia limitata | Eccellenti; calcolo remoto e visualizzazione fluida su Mac portatile |
| Rapporto Prezzo/Prestazioni | Sfavorevole; costi elevati per licenze VM e RAM unificata Apple | Ottimale; massima resa per unità di spesa nel calcolo 3D | Flessibile; tariffazione basata sull'effettivo consumo di ore macchina |
Per i professionisti che desiderano mantenere macOS come sistema operativo principale, l'approccio ottimale prevede l'adozione di sistemi di calcolo remoto come Vagon Cloud Computer o l'integrazione di server dedicati iRender, esternalizzando la fase di calcolo pesante su macchine Windows native dotate di GPU RTX della serie 50 e limitando l'uso di Parallels a semplici verifiche geometriche di emergenza o attività di modellazione poligonale di base. Alternativamente, si rende necessario il passaggio definitivo ad applicativi che supportino nativamente le API Metal RT e l'architettura dei SoC di Apple, come Blender o Autodesk Maya.
APPROFONDIMENTO: L'architettura doppia AI di ASUS TUF Gaming A14 FA401KM: analisi tecnica e guida operativa alle funzionalità locali
L'ASUS TUF Gaming A14 FA401KM introduce un'architettura a doppio acceleratore neurale con NPU AMD XDNA 2 e Tensor Core NVIDIA Blackwell, permettendo inferenza locale a bassa latenza, massima efficienza energetica e protezione dei dati. Questa guida analizza hardware, ripartizione dei carichi e configurazioni ottimali.
Analisi sistematica dell'hardware e ripartizione dei carichi computazionali
Il design termico dell'ASUS TUF Gaming A14 FA401KM rappresenta una sfida ingegneristica notevole: in uno chassis in alluminio da 1.46 kg e 1.69 cm di spessore, gli ingegneri hanno integrato un sistema a doppia ventola con 97 pale ultrasottili ciascuna, che convoglia l'aria attraverso la tastiera chiclet retroilluminata. Questo permette di dissipare il calore generato dai calcoli neurali e geometrici senza compromettere la portabilità. La macchina ospita componenti ad alta densità energetica, tra cui il processore AMD Ryzen AI 7 350 basato su architettura Krackan Point a 4nm, con 8 core e 16 thread suddivisi in 4 core Zen 5 fino a 5.0 GHz e 4 core Zen 5c fino a 3.5 GHz, con TDP configurabile da 15W a 54W. La memoria di sistema è di 32 GB LPDDR5X-7500 saldata on-board in dual-channel, garanzia di una larghezza di banda di 89.6 GB/s che evita colli di bottiglia nell'inferenza dei modelli linguistici locali. Lo storage è affidato a un SSD NVMe PCIe 4.0 da 1 TB alloggiato in uno dei due slot M.2 2280 disponibili, pensati per future espansioni dei modelli. Il display è un pannello da 14 pollici WQXGA 2560x1600 con formato 16:10, frequenza di aggiornamento a 165Hz, tempo di risposta di 3ms, copertura sRGB 100%, luminosità di 400 nits e supporto NVIDIA G-Sync con Advanced Optimus e MUX Switch. La webcam è 1080p FHD IR con array di microfoni bidirezionali, compatibile con Windows Hello per il riconoscimento biometrico. La tastiera offre corsa dei tasti di 1.7 mm e un tasto Copilot dedicato, mentre il touchpad in vetro migliora la precisione. La GPU discreta è una NVIDIA GeForce RTX 5060 Laptop con architettura Blackwell, 3328 CUDA core, 104 Tensor core di quinta generazione, 26 RT core di quarta generazione e 8 GB di VRAM GDDR7 su bus a 128-bit con 384 GB/s di banda passante. Il TGP massimo raggiunge i 105W con Dynamic Boost. Il sistema operativo è Windows 11 Home, predisposto per le API di intelligenza artificiale locali e la suite Copilot+ PC. Questa dotazione hardware si traduce in una gestione dinamica dei carichi: la CPU gestisce i flussi logici sequenziali e le operazioni standard, la NPU AMD XDNA 2 si occupa delle attività in background a bassissimo consumo come filtri video e trascrizioni audio, mentre la GPU interviene nei compiti di calcolo parallelo massivo come la grafica neurale e l'inferenza di modelli linguistici di grandi dimensioni.
| Componente | Specifica Tecnica Rilevata | Dettagli Architetturali e Implicazioni |
|---|---|---|
| Processore (CPU) | AMD Ryzen™ AI 7 350 | Architettura Krackan Point (TSMC 4nm), 8 core / 16 thread (4 Zen 5 fino a 5.0 GHz, 4 Zen 5c fino a 3.5 GHz), TDP configurabile 15W-54W. |
| Coprocessore AI (NPU) | AMD XDNA™ 2 | Array neurale a piastrelle di calcolo AIE-MLv2, fino a 50 TOPS in INT8. |
| Scheda Grafica Discreta (GPU) | NVIDIA® GeForce RTX™ 5060 Laptop | Architettura Blackwell GB206 (TSMC 4N 5nm), 3328 CUDA, 104 Tensor core 5a gen., 26 RT core 4a gen., TGP max 105W. |
| Memoria Video (VRAM) | 8 GB GDDR7 | Interfaccia 128-bit, banda 384 GB/s. |
| Memoria di Sistema (RAM) | 32 GB LPDDR5X-7500 | Saldatura on-board dual-channel, banda 89.6 GB/s. |
| Unità di Archiviazione | SSD 1 TB NVMe PCIe 4.0 | Slot M.2 2280, possibilità di espansione. |
| Display | 14" WQXGA 2.5K (2560x1600) | 16:10, 165Hz, 3ms, sRGB 100%, 400 nits, G-Sync, MUX Switch. |
| Dispositivi di Input | Tastiera retroilluminata, tasto Copilot | Corsa 1.7 mm, touchpad in vetro. |
| Acustica e Videocamera | Webcam 1080p FHD IR, microfoni bidirezionali | Supporto Windows Hello. |
| Sistema Operativo | Windows 11 Home | Integrazione API AI locali, Copilot+ PC. |
Caratteristiche della NPU AMD XDNA 2 e funzionalità Windows Studio Effects
La NPU AMD XDNA 2 rappresenta un'evoluzione dell'architettura di calcolo adattiva derivata da Xilinx, con un raddoppio dell'efficienza computazionale rispetto alla generazione precedente. Utilizza il formato "Block FP16" che unisce le alte prestazioni dei calcoli a 8 bit alla precisione matematica a 16 bit, eliminando la necessità di complessi processi di quantizzazione. Questo consente di eseguire modelli di visione artificiale e linguaggio naturale con fedeltà da server cloud ma consumando solo una frazione dell'energia della CPU. Windows Studio Effects sfrutta questa NPU per migliorare l'esperienza di webcam e microfoni durante videoconferenze e streaming, offrendo sfocatura dello sfondo, correzione del contatto visivo, inquadratura automatica e riduzione del rumore vocale. L'impatto energetico è estremamente basso, senza influire sulle prestazioni di gioco o rendering.
| Funzionalità AI | Acceleratore Primario | Framework / API | Impatto Energetico / Prestazionale |
|---|---|---|---|
| Windows Studio Effects | AMD XDNA 2 NPU | DirectShow / Windows Studio Effects Driver | Molto basso, nessun impatto su gaming. |
| NVIDIA DLSS 4 / 4.5 | RTX 5060 Tensor Cores | Direct3D 12 / NVIDIA Streamline | Medio, incremento frame rate fino a 8x. |
| Phi Silica (Local LLM) | RTX 5060 Laptop | Windows App SDK / Windows.AI.Text | Alto, uso intenso VRAM ma risposte istantanee. |
| Two-Way AI Noise Cancelation | CPU | ASUS Armoury Crate / Audio SDK | Molto basso, preserva CPU per gaming. |
| AI Aura Sync | CPU | ASUS Aura Creator / Armoury Crate | Trascurabile. |
| Amuse 2.0 (Stable Diffusion) | RTX 5060 + NPU | ONNX Runtime / DirectML / XDNA SR | Bilanciato, NPU riduce carico GPU del 30%. |
Per abilitare e personalizzare queste funzioni, l'operatore deve seguire una sequenza di passaggi strutturata all'interno del sistema operativo Windows 11.
| Fase | Procedura Operativa | Riscontro Visivo / Risultato Atteso |
|---|---|---|
| 1 | Richiamare le Impostazioni Rapide di Windows 11 cliccando sull'area dell'icona batteria/volume nell'angolo inferiore destro o premendo Windows + A. | Visualizzazione dei commutatori rapidi. Se la NPU è attiva, compare il pulsante "Effetti di Studio". |
| 2 | Cliccare su "Effetti di Studio" per accedere al menu a comparsa con i filtri della webcam. | Comparsa delle opzioni interattive per gestire flussi video e audio in tempo reale. |
| 3 | Selezionare "Effetti di Sfondo" e scegliere tra "Sfocatura Standard" o "Sfocatura Ritratto". | Applicazione istantanea della sfocatura selettiva sul flusso video, visibile nell'anteprima. |
| 4 | Abilitare "Contatto Visivo" selezionando la modalità "Standard" o "Teleprompter". | Allineamento digitale della pupilla con l'obiettivo, sguardo diretto e naturale. |
| 5 | Attivare l'interruttore "Inquadratura Automatica" (Auto Framing). | Zoom digitale intelligente che mantiene il volto centrato seguendo i movimenti laterali. |
| 6 | Abilitare "Voice Focus" nella sezione audio del pannello per la cancellazione del rumore sul microfono. | Isolamento della voce dai rumori d'ambiente a livello hardware, prima dell'invio al software. |
L'infrastruttura GPU NVIDIA Blackwell RTX 5060: Tensor Core e grafica neurale
La GPU NVIDIA GeForce RTX 5060 Laptop porta con sé l'architettura Blackwell, che introduce miglioramenti significativi nell'efficienza computazionale delle reti neurali profonde. I 104 Tensor Core di quinta generazione sono ottimizzati per l'elaborazione in formato FP4, consentendo di raddoppiare la capacità di calcolo senza saturare il bus a 128-bit della memoria GDDR7. La tecnologia DLSS 4 introduce il Multi Frame Generation, un modello neurale basato su Transformer visivi che genera fino a tre fotogrammi interpolati per ogni fotogramma renderizzato, moltiplicando il frame rate fino a 8x e riducendo l'uso di VRAM del 30%. NVIDIA Reflex 2 sincronizza CPU e GPU per latenze minime, mentre un sistema di metering hardware del flip stabilizza i tempi di visualizzazione, eliminando microscatti. Per configurare DLSS 4/4.5 e Reflex 2 sul dispositivo in esame, si consigliano le seguenti impostazioni.
| Fase | Istruzioni per la Configurazione | Dettagli Tecnici e Impostazioni Consigliate |
|---|---|---|
| 1 | Avviare l'applicazione NVIDIA App su Windows 11. | Se assente, scaricare la versione aggiornata dal portale ufficiale NVIDIA. |
| 2 | Accedere a Impostazioni > About e attivare l'accesso ai canali beta. | Consente di ricevere gli ultimi aggiornamenti dei modelli Transformer per DLSS 4.5. |
| 3 | Nella sezione Driver, eseguire l'installazione pulita del driver GeForce più recente (versione 591 o superiore). | Garantisce la presenza dei driver ottimizzati per Blackwell e le relative API. |
| 4 | Cliccare su Grafica e selezionare Impostazioni Globali. | Le modifiche si applicheranno automaticamente a tutti i software 3D supportati. |
| 5 | Individuare "DLSS override model presets" e impostare "Latest". | Sostituisce i modelli convoluzionali con Transformer, riducendo l'effetto "pittura". |
| 6 | (Opzionale) Nelle Impostazioni Programma, selezionare il gioco e impostare il preset DLSS su "Custom". | Sblocca preset personalizzati per il singolo titolo. |
| 7 | Impostare qualità super-risoluzione su Preset M o L per risoluzioni intermedie e attivare Multi Frame Generation. | Il Preset M garantisce migliore stabilità temporale su pannello 14" 2.5K. |
Integrazione delle API di Windows 11 e funzionalità locali Copilot+
L'ASUS TUF Gaming A14 FA401KM soddisfa i requisiti per l'ecosistema Microsoft Copilot+ grazie alla NPU da 50 TOPS. Windows 11 integra il modello linguistico locale Phi Silica, capace di elaborare compiti testuali offline, e le API Windows.AI.Text estendono il supporto alle GPU NVIDIA RTX, consentendo di sfruttare la potenza parallela della RTX 5060. Le principali funzioni locali includono TextRewriter (riscrittura del testo in Blocco Note o Edge), TextSummarizer (riassunti di articoli in Edge), TextToTableConverter (conversione di testo in tabelle), Live Captions (sottotitoli in tempo reale da oltre 40 lingue tramite NPU), Cocreator in MS Paint (generazione di immagini da descrizioni testuali) e Recall (ricerca semantica della cronologia attività). L'interazione è facilitata dal tasto Copilot dedicato sulla tastiera.
Suite software ASUS: Two-Way AI Noise Cancelation e AI Aura Sync
La suite Armoury Crate di ASUS offre algoritmi di machine learning per ottimizzare audio ed estetica. Two-Way AI Noise Cancelation filtra i rumori indesiderati su microfono e altoparlanti, utilizzando un modello di deep learning addestrato su oltre 500 milioni di campioni acustici per isolare la voce umana senza cali di frame rate. AI Aura Sync genera effetti di retroilluminazione dinamica per la tastiera a partire da descrizioni testuali. Di seguito la configurazione dettagliata.
| Fase | Procedura Operativa in Armoury Crate | Riscontro e Dettagli Applicativi |
|---|---|---|
| 1 | Avviare Armoury Crate dal menu Start o tasto dedicato. | Apertura della schermata di controllo centrale del notebook. |
| 2 | Nel pannello laterale sinistro, cliccare su Dispositivo > Sistema. | Accesso ai sottomenu di configurazione hardware e profili operativi. |
| 3 | Selezionare la scheda Audio nella parte superiore. | Visualizzazione delle impostazioni di cancellazione del rumore. |
| 4 | Commutare "Two-Way AI Noise Cancelation" su ON. | Attivazione del driver audio virtuale per i flussi filtrati. |
| 5 | Se compare notifica Realtek, cliccare OK e nella console Realtek Audio disattivare "Realtek Enhance Voice Recognition" su "All Off". | Previene conflitti software e distorsioni da filtri sovrapposti. |
| 6 | Selezionare l'intensità del filtro per Ingresso e Uscita: Low, Middle o High. | Modula la soppressione in base al rumore ambientale (tastiere, chiacchiericcio, lavori). |
| 7 | In app come Discord o Teams, impostare come dispositivi "AI Noise-Cancelling Input (ASUS Utility)" e "AI Noise-Cancelling Output (ASUS Utility)". Disattivare i filtri integrati dell'app. | Flusso audio elaborato localmente, voce nitida e senza latenze aggiuntive. |
| 8 | Per Aura Sync, navigare in Aura Effects, cliccare "AI Aura lighting effects", inserire un prompt (es. "onde oceaniche al tramonto") e cliccare "Genera". | Applicazione automatica di uno schema di illuminazione sincronizzato e coerente. |
Generazione di immagini offline con Amuse 2.0 e XDNA Super Resolution
Amuse 2.0 Beta, sviluppato da TensorStack con AMD, sfrutta l'architettura ibrida del notebook per la generazione locale di immagini. La GPU RTX 5060 esegue la generazione iniziale a 512x512 pixel, mentre la NPU XDNA 2 applica l'upscaling a 1024x1024 pixel tramite la tecnologia AMD XDNA Super Resolution, risparmiando circa il 30% di VRAM e accelerando i tempi. I 32 GB di memoria di sistema sono essenziali per caricare i modelli di diffusione senza rallentamenti. Ecco la procedura operativa.
| Fase | Istruzioni per Amuse 2.0 | Dettagli Operativi e Ottimizzazione |
|---|---|---|
| 1 | Scaricare l'eseguibile unico di Amuse 2.0 Beta (circa 800 MB) e installarlo. | Pacchetto autosufficiente, nessuna dipendenza esterna o configurazione da riga di comando. |
| 2 | Avviare il programma e verificare la spunta su "AMD XDNA Super Resolution" in basso. | Conferma del rilevamento dell'architettura XDNA 2 e abilitazione dell'upscaling hardware. |
| 3 | Impostare la qualità globale su "Balanced". | Ottimizza il numero di passaggi di Stable Diffusion per reattività e resa visiva. |
| 4 | In "Ez Mode", digitare il prompt descrittivo nel campo di testo principale. | Possibilità di inserire parole chiave o stili artistici (fotorealismo, cyberpunk). |
| 5 | (Opzionale) Utilizzare "Paint to Image" o "Drawing to Image" per importare un bozzetto guida. | Guida l'algoritmo nella strutturazione degli elementi geometrici della scena. |
| 6 | Cliccare su "Generate". | La GPU elabora a 512x512, la NPU esegue l'upscaling finale a 1024x1024. |
| 7 | Usare il cassetto "AI Filters" per applicare stili a foto esistenti. | Modifica estetica locale tramite filtri neurali avanzati. |
La configurazione hardware dell'ASUS TUF Gaming A14 FA401KM dimostra le potenzialità di un approccio ibrido all'intelligenza artificiale locale. La sinergia tra NPU e Tensor Core, unita ai 32 GB di memoria, permette di gestire carichi di lavoro continui a basso consumo e calcoli paralleli complessi, garantendo un'esperienza d'uso versatile, efficiente e protetta per le moderne applicazioni di calcolo neurale.
APPROFONDIMENTO: L'evoluzione dell'Edge AI nel personal computing: analisi tecnica del MacBook Air M5 13" con macOS 27 Golden Gate
L'ultraportatile Apple raggiunge una nuova maturità con il MacBook Air 13" dotato di chip M5 a 3 nanometri e macOS 27 Golden Gate. 16 GB di RAM unificata, 1 TB di SSD e Siri AI ridefiniscono l'edge computing, offrendo potenza da workstation in un corpo silenzioso e senza ventole.
Bonus Video
Contesto di mercato e posizionamento in Italia
La sovrapposizione concettuale tra le categorie di computer portatili consumer e professionali ha raggiunto un punto di svolta con la commercializzazione del MacBook Air 13'' equipaggiato con il processore Apple M5. Sebbene la denominazione storica del dispositivo rimanga ancorata al segmento ultraportatile, la specifica configurazione oggetto di questa analisi tecnica—caratterizzata da una CPU a 10 core, una GPU potenziata a 10 core, 16 GB di memoria unificata e ben 1 TB di archiviazione a stato solido (SSD) nella colorazione Mezzanotte—esibisce parametri hardware e potenzialità architetturali che storicamente appartenevano in via esclusiva alla linea MacBook Pro. Sotto l'egida di macOS 27 Golden Gate, attualmente rilasciato in versione beta per sviluppatori, questo dispositivo si propone come una workstation silenziosa ed efficiente per l'elaborazione di modelli di intelligenza artificiale locale ed edge computing.
In Europa e sul territorio italiano, il posizionamento commerciale del MacBook Air M5 riflette una strategia di continuità tariffaria e, al contempo, l'adeguamento a un quadro normativo peculiare. Il prezzo di listino ufficiale in Italia per la configurazione base di questo modello parte da € 1.249, mentre la variante potenziata con GPU a 10 core, 16 GB di RAM e 1 TB di SSD raggiunge un prezzo ufficiale di circa € 1.624. Per il canale accademico, Apple prevede un prezzo d'accesso agevolato di € 1.139 per il modello base.
Sul mercato dei rivenditori terzi in Italia, come Euronics e i distributori monitorati dalle piattaforme idealo e Trovaprezzi, si assiste a una sensibile oscillazione dei prezzi reali di vendita, con la configurazione base che scende frequentemente al di sotto della soglia dei € 1.000 e la versione da 1 TB rintracciabile in una fascia compresa tra € 1.399 e € 1.499, offrendo un eccellente rapporto qualità-prezzo per i professionisti in mobilità.
Un dettaglio logistico di rilievo per il mercato europeo riguarda la diversificazione del packaging istituzionale: in alcune giurisdizioni dell'Unione Europea, come il canale online irlandese, Apple ha introdotto opzioni di acquisto prive di alimentatore di ricarica incluso nella confezione base, richiedendo una spesa supplementare compresa tra € 45 e € 65 per l'aggiunta di un adattatore da 35W o 70W. Sul mercato italiano, la dotazione standard include tipicamente l'alimentatore dinamico da 40W con erogazione massima fino a 60W.
Sotto il profilo regolatorio, la distribuzione di macOS 27 Golden Gate nei paesi dell'Unione Europea beneficia di una distinzione cruciale rispetto ai sistemi operativi mobili di Apple. Poiché macOS non è soggetto alla designazione di "gatekeeper" ai sensi del Digital Markets Act (DMA) per quanto concerne i servizi di assistenza virtuale e intelligenza artificiale, le funzionalità evolute di Siri AI e della suite Apple Intelligence sono utilizzabili in Europa fin dalle prime versioni beta, aggirando le barriere burocratiche che hanno rallentato la distribuzione dei medesimi servizi su iOS.
L'unica limitazione di rilievo per l'utenza italiana è di natura linguistica: al lancio della beta, Siri AI supporta esclusivamente la lingua inglese, obbligando gli utenti a configurare il sistema operativo in tale idioma e a impostare la regione geografica sui parametri statunitensi per poter accedere alla lista d'attesa dei servizi cloud dedicati.
L'architettura del silicio: il chip Apple M5 e il coprocessore wireless N1
La spina dorsale del MacBook Air 13" è rappresentata dal system-on-a-chip (SoC) M5, un concentrato di silicio realizzato sulla base del processo produttivo a 3 nanometri ad alta densità (N3P) di TSMC. Sotto il profilo architetturale, la CPU adotta una struttura a 10 core complessivi, in cui spiccano 4 "super core" operanti a circa 4,4 GHz, coadiuvati da 6 core ad alta efficienza energetica. I super core beneficiano di una pipeline di decodifica a 10 istruzioni, la più ampia nel panorama dei processori consumer, affiancata da miglioramenti sostanziali nella gestione delle cache di primo e secondo livello e da un'unità di predizione dei rami potenziata. Tale impianto consente un incremento delle prestazioni multithread del 15% rispetto alla precedente generazione M4, esprimendo al contempo punteggi di assoluto rilievo nei test di calcolo a singolo core.
La vera rivoluzione prestazionale del chip M5 risiede tuttavia nella riprogettazione del sottosistema grafico. La GPU a 10 core integra, per la prima volta nella storia del silicio Apple, un modulo hardware denominato Neural Accelerator all'interno di ciascun singolo core grafico. Questa architettura di calcolo eterogeneo consente di eseguire operazioni di moltiplicazione di matrici ed elaborazione tensoriale in virgola mobile (FP16) direttamente all'interno della pipeline programmabile della GPU, senza dover scaricare interamente il carico di lavoro sul Neural Engine da 16 core. Grazie a questa sinergia e a una larghezza di banda della memoria unificata LPDDR5X-9600 incrementata a 153,6 GB/s, il chip M5 offre prestazioni di calcolo IA di picco quattro volte superiori rispetto alla famiglia M4 e fino a 9,5 volte superiori rispetto all'originale chip M1.
La connettività wireless è gestita dal chip proprietario Apple N1, che consolida in un singolo die di silicio i ricetrasmettitori Wi-Fi 7, Bluetooth 6 e Thread. Sotto l'aspetto implementativo, i test condotti da Ookla evidenziano che il silicio N1 apporta un incremento reale della larghezza di banda in download e upload fino al 40% rispetto alle soluzioni Broadcom precedentemente impiegate, distinguendosi in particolare per la capacità di ottimizzare le connessioni in condizioni non ideali (innalzando le prestazioni del decimo percentile).
Questo eccellente comportamento sul campo compensa una limitazione tecnica rilevata nei documenti di certificazione FCC: il chip N1 limita l'ampiezza del canale Wi-Fi 7 a un massimo di 160 MHz, non supportando la modalità a 320 MHz consentita dallo standard sulle frequenze dei 6 GHz. Nell'uso quotidiano, tale restrizione non influisce negativamente sulla maggior parte delle reti domestiche o aziendali europee, dove i canali a 320 MHz sono raramente configurabili a causa del sovraffollamento dello spettro elettromagnetico.
Il sistema operativo macOS 27 Golden Gate e la nuova Siri AI
Il rilascio della beta di macOS 27 Golden Gate, presentato ufficialmente durante la conferenza WWDC 2026, rappresenta un momento di cesura per l'ecosistema Mac. Oltre a sancire l'esclusione definitiva dei sistemi basati su processori Intel, il sistema operativo è stato ottimizzato per sfruttare le peculiarità della memoria unificata del silicio Apple.
Il pilastro portante di questa release è la profonda integrazione di Siri AI, un assistente virtuale chatbot-style ricostruito su un'architettura a tre livelli sviluppata in sinergia con Google e basata sulla famiglia di modelli Gemini. La distribuzione del carico computazionale di Siri AI avviene secondo criteri di massima efficienza e riservatezza: Livello On-Device, dove le richieste quotidiane, la catalogazione dei file locali e i compiti di automazione semplice vengono elaborati localmente dal chip M5 mediante modelli linguistici distillati e ottimizzati per il Neural Engine; Livello Private Cloud Compute, in cui le interrogazioni di complessità intermedia vengono indirizzate ai server sicuri di Apple, che operano elaborazioni crittografate e stateless, garantendo che i dati degli utenti non vengano archiviati o condivisi; Livello Cloud Gemini, per i compiti logici complessi che richiedono una conoscenza enciclopedica del web, le richieste vengono instradate a un modello Gemini da 1,2 trilioni di parametri operante su infrastrutture cloud dotate di acceleratori Nvidia B200. Prima della trasmissione, i sistemi di Apple rimuovono qualsiasi metadato identificativo o credenziale dell'Apple ID, garantendo l'anonimato assoluto della transazione informativa nei confronti dei server di Google.
L'interfaccia utente di Siri AI in macOS 27 supera i limiti del vecchio assistente vocale confinato nella barra dei menu. L'assistente è ora fuso con la barra di Spotlight tramite una sezione "Search or Ask" che risponde a comandi testuali o vocali. La finestra di conversazione può essere trascinata sullo schermo e ridimensionata a piacimento, comportandosi come un vero e proprio compagno di lavoro virtuale. L'interazione con il file system è potenziata dall'integrazione di Siri nei menu contestuali del Finder: selezionando più documenti e cliccando con il tasto destro, l'utente può attivare il campo "Ask Siri" per richiedere analisi comparative o riassunti immediati. Inoltre, la scorciatoia da tastiera dedicata alla Visual Intelligence permette di catturare porzioni dello schermo o finestre attive per chiedere delucidazioni, identificare elementi grafici o estrapolare codice sorgente.
Le funzionalità avanzate di scrittura e sintesi vocale di Siri AI beneficiano del quantitativo di memoria della macchina. L'esecuzione fluida dei modelli conversazionali più sofisticati, la regolazione del ritmo e dell'espressività vocale dell'assistente e il nuovo sottosistema di dettatura testuale richiedono un requisito minimo di 12 GB di RAM unificata, un valore ampiamente coperto dai 16 GB offerti di serie da questo MacBook Air M5. L'abbandono dell'architettura x86 porta con sé un'importante conseguenza per la stabilità del parco software legacy tramite l'annunciata dismissione dello strumento di traduzione Rosetta 2. Durante l'installazione di macOS 27 Golden Gate, il sistema provvede a disinstallare automaticamente Rosetta 2 se precedentemente presente. Sebbene sia ancora possibile reinstallarlo manualmente per questa release di transizione, Apple ha confermato che macOS 28 (previsto per l'autunno del 2027) eliminerà completamente il supporto generale a Rosetta 2, mantenendone solo un subset limitato per vecchi titoli videoludici non più aggiornati. Per i professionisti italiani ed europei del settore creativo, questo taglio netto rappresenta una criticità imminente, considerando che oltre 18.800 applicazioni e plug-in di terze parti dipendono ancora dall'emulazione x86 e cesseranno di funzionare se non ricompilati nativamente in formato Universal 2.
Funzionalità avanzate di Apple Intelligence e Safari
La suite di strumenti di intelligenza artificiale integrata in macOS 27 Golden Gate apporta miglioramenti mirati alla produttività quotidiana e all'editing multimediale. Nel comparto grafico, l'applicazione Foto viene dotata di algoritmi addestrati per l'elaborazione spaziale. Lo strumento "Spatial Reframing" analizza la composizione tridimensionale dell'immagine e consente di modificare la prospettiva e l'inquadratura dello scatto post-cattura, mentre la funzione "Extend" permette di allargare i confini di una foto generando i pixel mancanti in modo coerente con la texture, le ombre e le sorgenti di luce originali. Per preservare l'integrità dell'informazione visiva ed evitare la diffusione di falsi sintetici, ogni file modificato tramite queste funzioni riceve un watermark digitale invisibile SynthID.
Il browser Safari 27 implementa filtri intelligenti per la gestione della navigazione complessa. La funzione di organizzazione automatica raggruppa dinamicamente i pannelli aperti in categorie tematiche pertinenti, mentre l'opzione "Notify Me" monitora in background i siti di interesse (come portali di e-commerce o pagine di registrazione a eventi) per inviare notifiche istantanee all'utente non appena si verificano variazioni strutturali o aggiornamenti di prezzo. Di particolare interesse per l'utenza avanzata è la funzione "Describe an Extension", che consente di compilare estensioni personalizzate descrivendo in linguaggio naturale il comportamento desiderato; il motore di intelligenza artificiale traduce le istruzioni testuali in codice JavaScript e WebKit funzionante in tempo reale.
La scrittura di codice e l'automazione personale vengono semplificate all'interno dell'applicazione Shortcuts. L'interfaccia propone ora un'interazione basata sul linguaggio naturale che permette di generare flussi di lavoro complessi e correggere errori di sintassi semplicemente descrivendo a parole l'obiettivo desiderato. Nel campo della sicurezza, l'applicazione Passwords riceve un aggiornamento in grado di identificare le credenziali deboli o compromesse e di aggiornarle automaticamente con un solo tocco sui siti web compatibili.
Raffinamenti dell'interfaccia, connettività ed esperienza d'uso
Il rilascio di macOS 27 Golden Gate risponde in modo diretto alle critiche sollevate dall'utenza nei confronti del linguaggio estetico "Liquid Glass" introdotto con la precedente versione macOS 26 Tahoe. Sebbene lo stile traslucido di derivazione spaziale rimanga l'elemento cardine dell'interfaccia, Apple ha introdotto un cursore globale all'interno delle Impostazioni di Sistema che permette di regolare finemente il livello di opacità e l'effetto satinato degli elementi su schermo, andando incontro alle esigenze di chi predilige una visualizzazione più definita e meno distraente a vantaggio della produttività.
La geometria delle finestre è stata razionalizzata standardizzando il raggio di curvatura degli angoli e rimuovendo i fastidiosi doppi bordi lucidi che riducevano lo spazio utile. Le barre laterali delle applicazioni native si estendono ora fino al margine estremo della finestra di dialogo, eliminando lo sgradevole stacco visivo tipico di Tahoe e riacquistando le icone colorate per una più immediata identificazione visiva delle sezioni. Inoltre, l'interfaccia utente beneficia dell'implementazione del supporto HDR a livello di sistema, garantendo una riproduzione cromatica vibrante e un contrasto ottimale di testi e icone.
Sotto il profilo prestazionale, Golden Gate ottimizza le risorse hardware precaricando porzioni del codice delle applicazioni più utilizzate all'interno della memoria unificata, riducendo i tempi di avvio dei programmi fino al 30%. Le animazioni di sistema durante l'apertura delle app, la transizione tra le Scrivanie e l'attivazione di Mission Control sono state velocizzate, eliminando i micro-stutter e le incertezze che affliggevano i chip Apple Silicon con i precedenti software. La navigazione e la gestione delle informazioni traggono vantaggio dall'introduzione della gesture di trascinamento verso il basso (pull-to-refresh) all'interno delle applicazioni Safari, Mail, Calendario e Podcast, unificando l'esperienza d'uso con le piattaforme mobili di Apple.
La connettività esterna registra importanti aggiornamenti relativi alla gestione dei flussi video ad altissima risoluzione. Il MacBook Air M5 supporta il collegamento simultaneo di due display esterni anche con lo schermo integrato attivo, garantendo la persistenza del posizionamento delle finestre di lavoro tra le diverse sessioni. Il supporto per i monitor ultrawide è stato esteso per includere risoluzioni fino a 5K a 120Hz, mentre la funzionalità di mirroring dello schermo supporta ora una risoluzione di uscita in 6K. Per facilitare il monitoraggio delle connessioni di rete, l'icona dello stato della connessione Ethernet è ora visualizzabile direttamente all'interno della barra dei menu. L'applicazione iPhone Mirroring compie un significativo passo in avanti consentendo il ridimensionamento flessibile delle finestre delle app duplicate, l'accesso diretto al Centro di Controllo dell'iPhone abbinato e la riproduzione fluida di contenuti multimediali protetti da tecnologie DRM. Per la condivisione familiare, gli Album Condivisi di iCloud consentono ora lo scambio di immagini a piena risoluzione e sono aperti alla contribuzione di utenti operanti su piattaforme Windows e Android, con la possibilità di impostare date di scadenza temporali per i collegamenti di condivisione.
La sicurezza e la tutela dei minori sono state potenziate attraverso strumenti di parental control avanzati. Il sistema integra la funzione "Ask to Browse", che richiede l'approvazione esplicita dei genitori tramite un messaggio contestuale su Messages qualora il minore tenti di accedere a un dominio web non censito. La gestione del tempo d'uso ("Screen Time") permette di impostare calendari e limiti d'accesso differenziati per specifiche categorie di applicazioni (come Videogiochi, Intrattenimento e Social Network) a seconda dei giorni della settimana. Infine, i filtri di sicurezza attiva scansionano localmente i contenuti multimediali in entrata su FaceTime e Messages, oscurando immagini o video contenenti scene di violenza esplicita o nudità e avvisando tempestivamente l'utente.
Specifiche tecniche e prestazioni comparate
| Categoria Hardware | Dettagli Architetturali e Parametri di Funzionamento |
|---|---|
| Processore Principale | Apple M5 (10 core complessivi: 4 Super Core + 6 Efficiency Core) |
| Frequenza di Clock | ~4,4 GHz a regolazione dinamica in base al carico termico |
| Sottosistema Grafico | GPU a 10 core con Neural Accelerator per calcolo matriciale integrato |
| Unità di Calcolo IA | Neural Engine a 16 core ottimizzato per CoreML e Metal 4 |
| Memoria di Sistema | 16 GB di memoria unificata LPDDR5X operante a 9600 MT/s |
| Larghezza di Banda RAM | 153,6 GB/s a condivisione dinamica tra CPU, GPU e NPU |
| Unità di Archiviazione | SSD proprietario da 1 TB con controller a doppia velocità |
| Pannello Display | Liquid Retina IPS da 13,6", risoluzione 2560x1664 a 224 ppi |
| Parametri Display | Luminosità di 500 nit, gamma cromatica P3, supporto Dolby Vision e HDR10 |
| Sottosistema Wireless | Apple N1: Wi-Fi 7 (limitato a 160 MHz), Bluetooth 6.0, Thread |
| Alimentazione e Batteria | Batteria ai polimeri di litio da 53,8 Wh con autonomia fino a 18 ore |
| Configurazione MacBook Air M5 13" | Prezzo Ufficiale Italia / UE | Street Price Medio Italia | Dotazione Alimentatore inclusa nella confezione |
|---|---|---|---|
| 10C CPU, 8C GPU, 16GB, 512GB | € 1.249 | € 982 - € 1.099 | Adattatore 40W Dynamic (60W Max) |
| 10C CPU, 10C GPU, 16GB, 1TB | € 1.624 | € 1.399 - € 1.499 | Adattatore 40W Dynamic (60W Max) |
| 10C CPU, 10C GPU, 24GB, 1TB | € 1.749 | € 1.599 - € 1.699 | Adattatore 40W Dynamic (60W Max) |
| 10C CPU, 10C GPU, 32GB, 1TB | € 1.999 | € 1.849 - € 1.899 | Adattatore 40W Dynamic (60W Max) |
| Modello di Dispositivo Apple | Punteggio CPU Singolo Core | Punteggio CPU Multi Core | Prestazioni Grafiche Metal |
|---|---|---|---|
| MacBook Air M5 (Configurazione in Esame) | 4.268 | 17.073 | 56.800 |
| MacBook Air M4 (Generazione Precedente) | 3.820 | 14.731 | 42.100 |
| MacBook Air M3 (Due Generazioni Precedenti) | 3.110 | 12.020 | 34.500 |
| MacBook Air M1 (Modello di Riferimento) | 2.340 | 8.342 | 21.000 |
| MacBook Pro M5 Max (Riferimento High-End) | 4.268 | 29.233 | 225.400 |
Analisi dei punti di forza e debolezza
L'adozione del MacBook Air 13" con chip M5 in combinazione con la beta di macOS 27 Golden Gate evidenzia un quadro composto da elementi di eccellenza ingegneristica e da inevitabili limitazioni funzionali, che devono essere attentamente soppesati dagli utenti professionali. Tra i punti di forza spicca senza dubbio l'introduzione di 16 GB di memoria unificata come dotazione standard di partenza. Questa scelta architetturale elimina una storica limitazione dei modelli Air di base, consentendo il caricamento e l'esecuzione locale di modelli di linguaggio di grandi dimensioni (LLM) senza incorrere in fenomeni di saturazione della memoria o rallentamenti causati dal ricorso alla memoria virtuale di scambio.
La riprogettazione dei core della GPU tramite i Neural Accelerator garantisce un'efficienza energetica senza precedenti nell'esecuzione dei calcoli di intelligenza artificiale edge. Poiché i calcoli matriciali complessi vengono elaborati direttamente dai core grafici con un consumo energetico frazionato, il computer mantiene temperature di esercizio estremamente basse e non necessita di sistemi di raffreddamento attivi a ventola, preservando l'autonomia della batteria fino a 18 ore anche sotto carichi di lavoro continuativi. L'incremento prestazionale del sottosistema di archiviazione a stato solido da 1 TB, le cui velocità di lettura e scrittura risultano raddoppiate rispetto ai controller della passata generazione, riduce drasticamente i tempi di boot del sistema e velocizza l'importazione di pesanti database di dati o di librerie multimediali. Infine, l'implementazione del chip N1 garantisce una stabilità di connessione wireless di alto livello, incrementando in modo sensibile la velocità di trasferimento dei dati tramite AirDrop e la reattività dei collegamenti in mobilità.
I punti di debolezza, d'altro canto, risiedono in gran parte nelle scelte di transizione tecnologica di Apple e in alcune concessioni conservative sul piano hardware. La rimozione forzata di Rosetta 2 durante l'aggiornamento a macOS 27 pone un serio problema di compatibilità per chiunque utilizzi il Mac per scopi professionali al di fuori dei software nativi già aggiornati all'architettura ARM. Il venir meno della compatibilità generale con l'universo x86 entro l'autunno del 2027 costringerà molti studi di produzione musicale, agenzie di sviluppo software e uffici tecnici a congelare i propri sistemi operativi alla versione attuale o a pianificare costose sostituzioni delle proprie catene di strumenti di terze parti e plug-in legacy. A livello hardware, la scelta di limitare lo standard Wi-Fi 7 a un'ampiezza di canale di 160 MHz appare come un inutile compromesso conservativo, che impedisce alla macchina di sfruttare appieno la velocità massima teorica consentita dai router di nuova generazione. Inoltre, lo chassis esterno non ha ricevuto alcun aggiornamento estetico e continua a montare un pannello IPS limitato a una frequenza di aggiornamento di 60 Hz. La mancanza di uno schermo OLED o dell'alto refresh rate ProMotion a 120 Hz riduce l'appeal visivo del dispositivo nel confronto con la concorrenza di fascia alta in ambito Windows. Infine, la colorazione Mezzanotte (Midnight) scelta per questa configurazione, pur estremamente elegante, si conferma soggetta a trattenere le impronte digitali e i piccoli segni di usura, richiedendo una manutenzione estetica costante.
Il MacBook Air 13" con chip M5 e macOS 27 Golden Gate si configura come un dispositivo di transizione cruciale, capace di traghettare l'utenza verso una nuova era di calcolo incentrata sull'intelligenza artificiale distribuita e sul superamento definitivo dell'architettura Intel. Per i professionisti della scrittura, i programmatori e i creatori di contenuti multimediali leggeri, questa configurazione rappresenta una scelta ottimale; per gli specialisti del software legacy si raccomanda invece prudenza, pianificando la migrazione solo dopo una verifica accurata della compatibilità nativa con Apple Silicon.
Di Alex (del 16/06/2026 @ 10:00:00, in Storia Impero Romano, letto 465 volte)
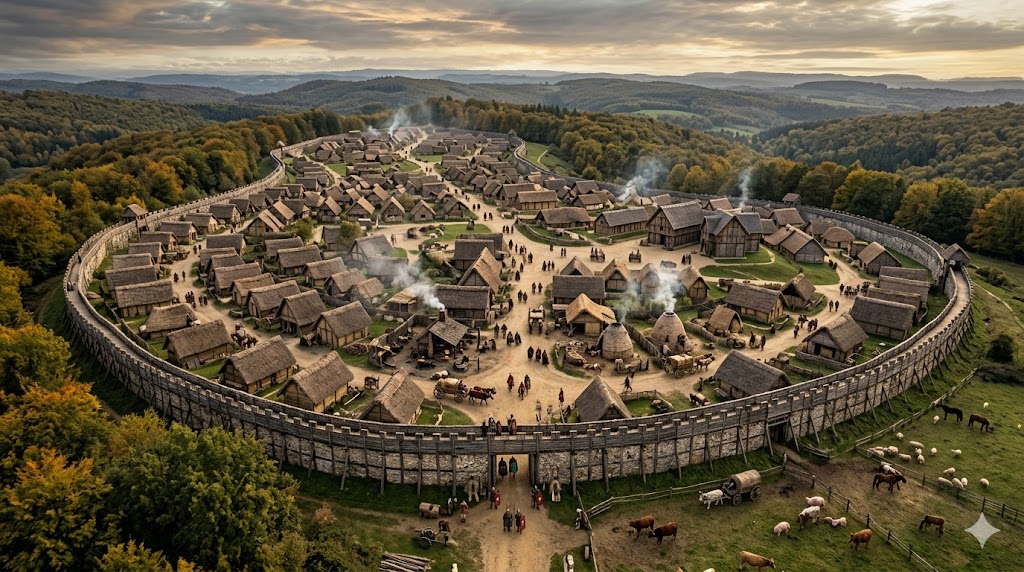
Ricostruzione di Bibracte con le mura murus gallicus e le case celtiche
Bonus Video
Le mura di legno e ferro che sfidavano la topografia
Il Mont Beuvray, un altopiano di origine vulcanica che si eleva a 821 metri sul livello del mare, domina un paesaggio di boschi di querce e pascoli che ancora oggi conserva l’impronta dell’oppidum celtico. Gli scavi francesi e internazionali, coordinati dal Centre archéologique européen du Mont Beuvray dal 1984, hanno documentato una superficie abitata di circa 135 ettari, delimitata da una doppia cinta di fortificazioni del tipo noto come murus gallicus, descritta minuziosamente da Giulio Cesare nel De Bello Gallico. La struttura consisteva in travi di quercia disposte a graticcio, fissate con lunghi chiodi di ferro e riempite con massi di granito e argilla: una soluzione che combinava l’elasticità del legno con la resistenza alla compressione della pietra, capace di assorbire i colpi degli arieti senza crollare.
Le datazioni dendrocronologiche effettuate su alcune travi carbonizzate indicano fasi di costruzione successive tra il 120 e l’80 avanti Cristo, con un ampliamento repentino intorno al 58 avanti Cristo, probabilmente in risposta alle campagne cesariane. La porta principale, la cosiddetta “Porte du Rebout”, conserva ancora l’impronta delle ruote dei carri che vi transitavano, calcolate in circa novemila passaggi all’anno durante il periodo di massima attività.
Quartieri specializzati e scambi su scala continentale
La pianta della città, ricostruita grazie alle prospezioni geomagnetiche e ai saggi stratigrafici, rivela una zonizzazione funzionale molto avanzata: un quartiere settentrionale dedicato alla metallurgia del ferro, con oltre duecento forni a riduzione, uno centrale per la lavorazione del bronzo e dell’argento, e uno meridionale per la produzione di ceramiche fini da mensa e anfore vinarie. Le scorie di ferro indicano un volume produttivo annuo di circa venti tonnellate, sufficiente a rifornire l’intera Gallia centrale e a generare un surplus esportato verso le tribù belgiche e alpine.
La posizione geografica di Bibracte, all’incrocio tra le valli della Loira e della Saona, ne faceva un hub naturale per gli scambi a lunga distanza. Le anfore vinarie provenienti dall’Italia, le ceramiche campane a vernice nera, le fibule di bronzo della Cisalpina e le monete d’argento dei Tectosagi circolavano quotidianamente nei mercati all’aperto, mentre i mercanti italici stabilitisi in loco introdussero l’uso di pesi e bilance romane accanto ai tradizionali sistemi di conteggio celtici basati su verghe di metallo.
| Quartiere | Superficie | Produzione principale | Periodo |
|---|---|---|---|
| Metallurgico nord | 15 ettari | Ferro semilavorato | 120-50 avanti Cristo |
| Artigianato bronzo | 8 ettari | Monili, armi da parata | 100-50 avanti Cristo |
| Ceramico sud | 10 ettari | Vasi a tornio veloce | 80-40 avanti Cristo |
| Commercio centrale | 12 ettari | Import-export | 120-40 avanti Cristo |
| Religioso sommitale | 5 ettari | Riti druidici | 150-50 avanti Cristo |
Da capitale celtica a città abbandonata
Bibracte fu il luogo dove, nel 52 avanti Cristo, i delegati delle tribù galliche riunirono l’assemblea che nominò Vercingetorige comandante supremo della coalizione antiromana. Cesare vi soggiornò nell’inverno successivo per dettare i Commentarii, ma il destino della città era già segnato: la fondazione di Augustodunum, l’attuale Autun, a una ventina di chilometri di distanza, decretò il progressivo trasferimento della popolazione e la fine dell’oppidum. Il sito venne riscoperto solo nel XIX secolo e oggi è un laboratorio a cielo aperto dove archeologi sperimentali ricostruiscono le tecniche costruttive celtiche, dimostrando che la cultura gallica raggiunse livelli di complessità urbana che nulla avevano da invidiare alle coeve città mediterranee. Bibracte rimane il simbolo di una civiltà celtica colta, organizzata e aperta al mondo, che seppe resistere fino all’ultimo prima di essere assorbita dall’impero, lasciando tracce che ancora oggi riemergono tra i boschi della Borgogna.
Di Alex (del 16/06/2026 @ 11:00:00, in Storia Impero Romano, letto 457 volte)
Sezione di calcestruzzo cartaginese con inclusi ceramici
Bonus Video
La scoperta che sfida la supremazia romana
Nel 2009 un’équipe di geologi dell’Università di Tunisi, impegnata nel consolidamento delle rovine del porto punico, notò che le strutture sommerse dei moli, datate al III secolo avanti Cristo, presentavano una resistenza alla compressione sorprendentemente elevata, prossima a quella di un calcestruzzo moderno di classe C20/25. Le analisi diffrattometriche e petrografiche svelarono una composizione che nulla aveva da invidiare al più celebre opus caementicium romano: una matrice di calce ottenuta per calcinazione di calcari dolomitici locali, aggregati di sabbia quarzosa e, soprattutto, una frazione fine di cocciopesto, ovvero ceramica macinata, presente in percentuali comprese tra il 18 e il 25 per cento del volume totale.
La vera peculiarità emerse quando i campioni vennero esposti a cicli di immersione in acqua marina e asciugatura, simulando le condizioni del porto: la resistenza meccanica, invece di diminuire, aumentò del 12 per cento nell’arco di sei mesi. I ricercatori scoprirono che la calce dolomitica, combinata con i silicati della ceramica e l’anidride carbonica disciolta nell’acqua, generava cristalli di calcite secondaria che andavano a riempire le microfratture, innescando un meccanismo di autoriparazione del tutto analogo a quello recentemente individuato nel calcestruzzo romano del Pantheon.
Una ricetta custodita dai sacerdoti di Baal
Le fonti greche e latine accennano sporadicamente a un “cemento libico” o “bitume cartaginese”, ma i dettagli tecnici erano custoditi gelosamente dai collegi sacerdotali legati al tempio di Eshmun, il dio guaritore. La produzione richiedeva temperature di calcinazione più basse rispetto alla calce romana, attorno ai 700 gradi centigradi, consentendo un risparmio di combustibile e una minore emissione di anidride carbonica. I frammenti ceramici, provenienti dagli scarti delle fornaci di anfore, venivano macinati a granulometria controllata e aggiunti alla miscela in proporzioni che variavano a seconda della destinazione d’uso: più fine per le cisterne, dove la tenuta idraulica era critica, più grossolana per i muri di terrazzamento delle colline di Byrsa.
Le prove di laboratorio condotte nel 2016 dal Politecnico di Milano hanno dimostrato che il calcestruzzo cartaginese, pur avendo una resistenza iniziale inferiore a quella romana, raggiungeva i 15 megapascal dopo 28 giorni e continuava a stagionare per anni, mantenendo una duttilità che lo rendeva meno soggetto a fessurazioni in zona sismica. Questo spiegherebbe la longevità delle fortificazioni di Lilibeo, in Sicilia, che resistettero per dieci anni all’assedio romano durante la prima guerra punica.
| Componente | Percentuale | Origine | Effetto |
|---|---|---|---|
| Calce dolomitica | 30-35% | Calcari locali tunisini | Legante idraulico |
| Sabbia quarzosa | 40-45% | Costa di Cartagine | Aggregato inerte |
| Cocciopesto ceramico | 18-25% | Fornaci urbane | Pozzolanico, autoriparante |
| Acqua di mare | 5% | Porto | Attivazione reazioni |
| Fibre vegetali | 1-2% | Palmeti | Armatura diffusa |
L’eredità cancellata e le possibili applicazioni odierne
La distruzione totale di Cartagine e la damnatio memoriae imposta da Roma cancellarono ogni traccia scritta della tecnologia costruttiva punica, ma sopravvissero tradizioni orali tra i berberi del Maghreb, che continuarono a usare impasti di calce e cocciopesto per i pozzi e le cisterne delle oasi fino al XIX secolo. Oggi, in un’epoca in cui l’industria del cemento è responsabile di circa l’8 per cento delle emissioni globali di CO2, la riscoperta del calcestruzzo cartaginese non ha solo un valore storico: le simulazioni condotte dall’Università di Cambridge nel 2022 suggeriscono che una formulazione ispirata a quella punica, utilizzando rifiuti ceramici industriali al posto del clinker, potrebbe ridurre l’impronta carbonica di un terzo e prolungare la vita utile delle infrastrutture costiere. La vicenda dimostra come la storia della tecnica sia un serbatoio di soluzioni dimenticate che la scienza contemporanea sta solo cominciando a esplorare. Il calcestruzzo di Cartagine, ignorato per oltre due millenni, riaffiora oggi come una lezione di sostenibilità ante litteram: un materiale che univa scarti industriali, chimica dei silicati e resilienza sismica in un equilibrio che i Romani non riuscirono mai a eguagliare del tutto.
Di Alex (del 16/06/2026 @ 12:00:00, in Storia Impero Romano, letto 547 volte)
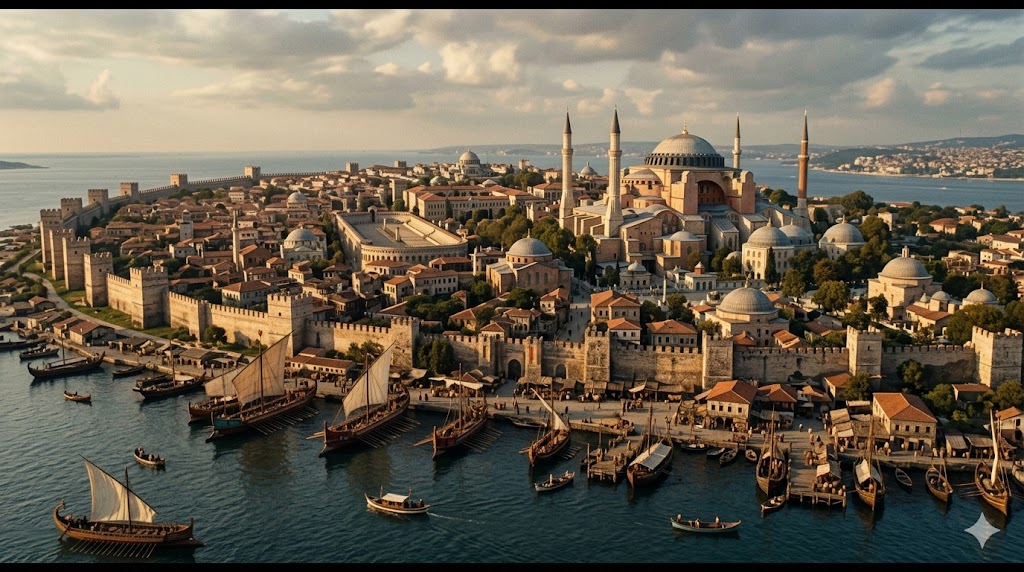
Veduta di Costantinopoli con la basilica di Santa Sofia e le mura teodosiane
Bonus Video
Le mura che ressero un millennio
La cinta difensiva fatta erigere dall’imperatore Teodosio II nel 413 dopo Cristo e rafforzata dopo il terremoto del 447 dopo Cristo costituiva il più sofisticato sistema di fortificazione terrestre mai realizzato fino ad allora. Tre ordini paralleli di difesa – un fossato largo venti metri, un antemurale merlato e la muraglia principale alta dodici metri con torri a pianta esagonale o ottagonale distanziate di circa sessanta metri – garantivano una profondità difensiva di oltre sessanta metri, moltiplicando le linee di fuoco per gli arcieri e le catapulte. I mattoni e i blocchi di calcare provenivano dalle cave del mar di Marmara, e le malte idrauliche, analizzate nel 2013 dall’Università del Bosforo, mostravano una composizione simile a quella del cemento romano, con aggiunta di pozzolana di Santorini che ne aumentava la resistenza all’azione corrosiva delle piogge.
La Porta d’Oro, rivestita di lastre d’ottone e sormontata da una quadriga di elefanti bronzei, non era solo un ingresso trionfale ma un manifesto ideologico: da lì entravano i generali vittoriosi e gli ambasciatori stranieri, mentre le reliquie dei santi venivano portate in processione lungo la via Mese fino al Grande Palazzo. Nel 550 dopo Cristo, sotto Giustiniano I, le mura proteggevano una popolazione stimata in quattrocentosettantamila anime, il doppio di Roma nello stesso periodo, e le caserme dei tagmata, i reggimenti di élite, presidiavano i settori critici con turni di guardia che si susseguivano senza interruzione.
Santa Sofia, un miracolo di geometria e luce
Consacrata il 27 dicembre del 537 dopo Cristo dopo cinque anni di lavori che avevano impiegato oltre diecimila operai, la basilica dedicata alla Divina Sapienza sbalordiva i contemporanei non solo per le dimensioni – 82 metri di lunghezza, 73 di larghezza e una cupola di 31 metri di diametro sospesa a 56 metri dal pavimento – ma per l’effetto di smaterializzazione delle pareti, prodotto da quaranta finestre disposte alla base della calotta. Procopio di Cesarea, nel suo trattato “Sugli edifici”, descrisse la cupola come “appesa al cielo per mezzo di una catena d’oro”, e i calcoli statici moderni confermano che i pennacchi sferici, innovazione assoluta per l’epoca, distribuivano il peso sui quattro pilastri principali con una tolleranza di pochi centimetri.
L’interno era un tripudio di marmi policromi provenienti da tutto il Mediterraneo: verde di Tessaglia, porfido rosso d’Egitto, giallo antico di Chemtou, che venivano segati in lastre sottili e accostati a libro in modo da creare un effetto di simmetria speculare che alludeva all’ordine divino. Il pavimento, leggermente convesso per favorire il drenaggio durante le grandi liturgie, era percorso da guide di bronzo che orientavano i fedeli verso l’ambone, mentre un sistema di tubature in piombo portava l’acqua piovana raccolta dalla cupola alle cisterne sotterranee, garantendo autonomia idrica anche in caso di assedio.
| Quartiere | Abitanti stimati | Funzione | Infrastruttura chiave |
|---|---|---|---|
| Zeugma | 80.000 | Commercio portuale | Molo del Corno d’Oro |
| Mese | 120.000 | Residenze e botteghe | Foro di Costantino |
| Grande Palazzo | 15.000 | Corte imperiale | Cisterna Basilica |
| Blacherne | 50.000 | Religioso e difensivo | Santuario della Vergine |
| Quartieri latini | 25.000 | Ambasciate e mercanti | Ospedale di Sampson |
La vita quotidiana nella Nuova Roma
I registri dell’annona, l’ufficio imperiale addetto alla distribuzione alimentare, indicano che ogni giorno entravano in città circa tremila tonnellate di grano egiziano, scaricate nei granai del porto di Giuliano e razionate attraverso un sistema di tessere di piombo che permetteva a ogni capofamiglia di ritirare sei pani al giorno. Le terme pubbliche, le botteghe di profumieri siriani, i laboratori di ebanisti copti e i mercati del pesce del Corno d’Oro creavano un brulichio multietnico che scandalizzava i pellegrini occidentali, abituati a città molto più piccole e omogenee. Nel 550 dopo Cristo, mentre in Occidente i regni barbarici si spartivano le spoglie dell’impero, Costantinopoli continuava a essere il faro di una civiltà che si percepiva come eterna, e che in effetti sarebbe sopravvissuta ancora nove secoli prima di cadere sotto i cannoni ottomani. Costantinopoli non era solo la città più grande del mondo cristiano: era una macchina urbana progettata per resistere agli assedi, alle carestie e ai terremoti, alimentata da un’economia globale e governata da una burocrazia che costituiva l’autentico sistema nervoso dell’impero.
Il robot umanoide Figure 03 in un ambiente domestico con oggetti da manipolare
Bonus Video
La visione artificiale e i nuovi sensori palmari
Il salto generazionale rispetto al modello 02 risiede innanzitutto nella testa sensorizzata: il sistema di visione stereoscopica è stato potenziato con fotocamere che operano a novanta fotogrammi al secondo, il doppio della versione precedente, consentendo all’unità di elaborazione neurale di tracciare oggetti in movimento rapido e di mantenere la messa a fuoco anche in condizioni di scarsa illuminazione fino a cinque lux. La latenza end-to-end, misurata dal momento in cui un fotone colpisce il sensore a quando l’attuatore corrispondente riceve il comando, è scesa da trentadue millisecondi a otto millisecondi, grazie a un nuovo processore neuromorfico sviluppato internamente e a una memoria cache di livello quattro che elimina i colli di bottiglia del bus di comunicazione. Il campo visivo per singolo occhio si estende ora su un angolo solido di 160 gradi contro i 100 gradi della generazione precedente, permettendo al robot di coprire l’intera area antistante senza dover ruotare il busto.
Un’innovazione radicale è rappresentata dalle due microcamere integrate nei palmi delle mani, protette da un vetro zaffiro antigraffio, che forniscono una vista ravvicinata della presa con risoluzione 4K e consentono di calibrare la forza in tempo reale incrociando i dati visivi con quelli provenienti dai sensori capacitivi distribuiti sulle falangi. Questi ultimi, costituiti da una matrice di 256 microelettrodi per dito, possono rilevare pressioni a partire da 0,03 newton, equivalenti al peso di una moneta da un centesimo, rendendo possibile afferrare un uovo senza romperlo o manipolare una penna senza farla scivolare.
Produzione di massa e test sul campo
L’azienda californiana Figure AI ha dichiarato l’intenzione di avviare la produzione in serie entro la fine del 2026 presso lo stabilimento di Sunnyvale, con una capacità installata di 12.000 unità all’anno, scalabile a 100.000 unità nel giro di quattro esercizi grazie a un investimento di 670 milioni di dollari da parte di un consorzio che include fondi di venture capital e un grande costruttore automobilistico tedesco. La scelta di puntare su una produzione così elevata si basa sui risultati conseguiti dal modello 02, attualmente in servizio da cinque mesi nello stabilimento BMW di Spartanburg, in Carolina del Sud, dove opera su turni di dieci ore consecutive con un tempo medio tra i guasti inferiore alle mille ore.
Durante il test, il robot 02 ha eseguito operazioni di assemblaggio di componenti elettrici, carico e scarico di container e ispezione visiva di saldature, con un tasso di errore dello 0,2 per cento, paragonabile a quello di un operatore umano con tre anni di esperienza. I dati raccolti hanno permesso di affinare gli algoritmi di apprendimento per imitazione, che nel modello 03 vengono eseguiti su un cluster di addestramento dedicato con 4.000 GPU, riducendo il tempo di apprendimento di una nuova mansione da due giorni a meno di sei ore.
| Specifica | Figure 02 | Figure 03 | Variazione |
|---|---|---|---|
| Altezza | 168 cm | 170 cm | +1,2% |
| Peso | 60 kg | 58 kg | -3,3% |
| Fotogrammi al secondo | 45 | 90 | +100% |
| Latenza | 32 ms | 8 ms | -75% |
| Campo visivo per occhio | 100° | 160° | +60% |
| Sensibilità tattile | 0,1 N | 0,03 N | -70% |
Prospettive e scetticismi
Nonostante i progressi tangibili, la comunità scientifica rimane cauta. Le sfide della deambulazione su superfici irregolari, dell’autonomia energetica, che attualmente si attesta sulle quattro ore, e della sicurezza intrinseca in spazi condivisi con esseri umani sono lontane dall’essere risolte. Figure AI sta collaborando con il National Institute of Standards and Technology per sviluppare un framework di certificazione che copra scenari di caduta, manipolazione di oggetti taglienti e risposta a comandi vocali ambigui. Se queste tappe verranno superate, il 2027 potrebbe segnare l’inizio di una nuova era in cui gli umanoidi non saranno più confinati ai laboratori di ricerca ma entreranno stabilmente nella vita quotidiana, gestendo camere d’albergo, scaffali di supermercati e pacchi di logistica con una precisione oggi impensabile. Figure 03 incarna la scommessa più audace della robotica contemporanea: costruire un automa versatile e prodotto in massa che non sostituisca l’uomo ma ne amplifichi le capacità, aprendo la strada a un’economia ibrida in cui la collaborazione tra intelligenza organica e artificiale diventa la norma.
Di Alex (del 16/06/2026 @ 14:00:00, in Storia Medioevo, letto 443 volte)
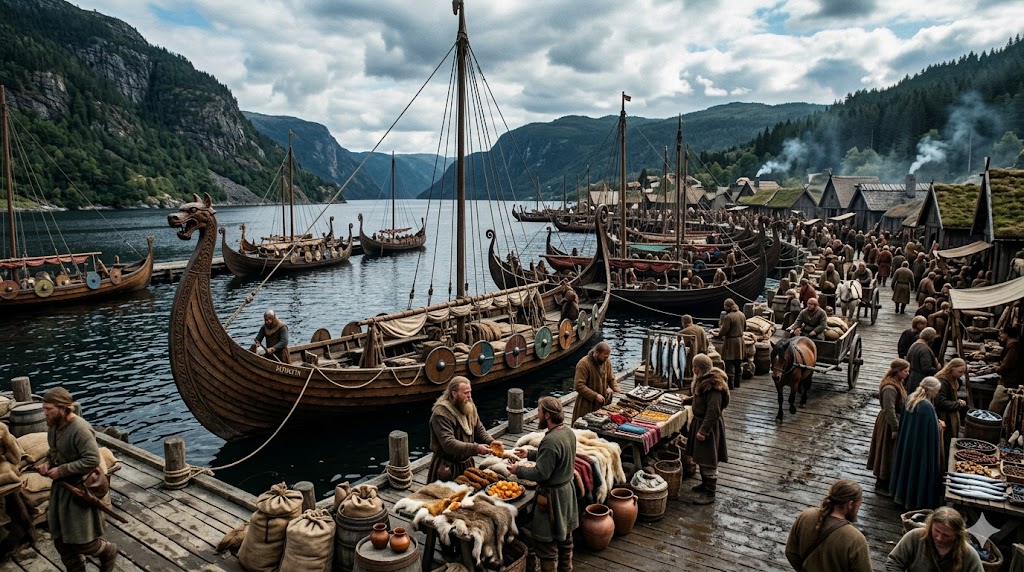
Ricostruzione del porto commerciale di Kaupang in Norvegia
Bonus Video
Le origini di un nodo commerciale
Gli scavi condotti a partire dal 1867 e ripresi sistematicamente negli anni ‘90 del Novecento hanno restituito la pianta di un insediamento che si estendeva per circa 54 ettari lungo la riva occidentale del fiordo di Oslo, nel territorio che oggi appartiene al comune di Larvik. La datazione dei reperti colloca la fondazione attorno al 780 dopo Cristo, in coincidenza con l’inizio delle grandi migrazioni vichinghe, ma la scelta del sito non fu casuale: la baia di Kaupang, riparata dai venti e sufficientemente profonda per le chiglie delle navi mercantili, costituiva uno dei pochi approdi naturali tra lo Skagerrak e la costa frastagliata del Vestfold. Le prospezioni geofisiche hanno inoltre individuato un sistema di canali dragati artificialmente per consentire l’attracco simultaneo di almeno venti imbarcazioni, un investimento infrastrutturale che nessun altro centro coevo scandinavo poteva vantare.
Bonus Video
Le fonti scritte sono quasi inesistenti, ma il resoconto del mercante anglosassone Wulfstan, che intorno all’890 dopo Cristo descrisse un emporio chiamato “Sciringes heal”, viene oggi quasi unanimemente identificato con Kaupang. Wulfstan riferì di un porto affollato da navi provenienti dalla Frisia, dalla Sassonia e dalla Danimarca, dove si potevano acquistare zanne di tricheco, pellicce di orso bruno, cordame di canapa e, soprattutto, schiavi catturati lungo le coste del Baltico. L’elemento più sorprendente è la quantità di argento rinvenuta: oltre 800 monete arabe, principalmente dirham coniati dalla dinastia abbaside, tagliati in frammenti per essere pesati con bilancini a piatti, dimostrano che Kaupang era il terminale settentrionale di una catena di scambi che partiva dalle miniere dell’Hindu Kush e attraversava il Khazaro, la Rus’ di Kiev e il Baltico.
I reperti che raccontano un’economia globale
La stratigrafia delle aree di scavo ha svelato botteghe artigianali disposte a schiera lungo strade di assi di legno, ciascuna specializzata in una filiera produttiva. Nella zona settentrionale sono stati trovati resti di fucine con crogioli contenenti tracce di rame, argento e oro, interpretate come officine per la produzione di gioielli e amuleti destinati sia al mercato locale sia all’esportazione verso le élite anglosassoni. Le analisi metallografiche dei crogioli rivelano una lega di provenienza insulare britannica, segno che i metalli preziosi giungevano in Norvegia già sotto forma di oggetti saccheggiati e venivano rifusi sul posto.
Nella fascia centrale dell’insediamento gli archeologi hanno portato alla luce decine di telai a pesi per la tessitura della lana, accanto a depositi di semi di lino che indicano una coltivazione intensiva nelle campagne retrostanti. I tessuti di Kaupang, tinti con erica e licheni, venivano scambiati con pellicce di volpe artica e zibellino raccolte dai cacciatori sami, creando un flusso commerciale che seguiva un asse nord-sud parallelo alla costa. La quantità di ambra grezza e lavorata, circa 40 chilogrammi, testimonia inoltre un rapporto diretto con le coste meridionali del Baltico: l’analisi spettroscopica ha identificato la resina fossile come proveniente dalla regione di Sambia, l’odierna Kaliningrad, trasformata a Kaupang in perle e pendenti.
| Merce | Provenienza | Quantità rinvenuta | Destinazione |
|---|---|---|---|
| Dirham d’argento | Califfato abbaside | 832 frammenti | Circolazione locale e baltica |
| Ambra grezza | Sambia (Baltico) | 40 kg | Frisia, Inghilterra |
| Perle di vetro | Mediterraneo orientale | 1.200 unità | Tutta la Scandinavia |
| Pettini in osso di cervo | Norvegia meridionale | 450 esemplari | Danimarca, Islanda |
| Schiavi (stima indiretta) | Coste baltiche | Centinaia all’anno | Mercati arabi via Rus’ |
Il declino e l’eredità di Kaupang
Intorno al 930 dopo Cristo le tracce di attività cessano bruscamente. Le ipotesi più accreditate chiamano in causa l’insabbiamento del porto, causato dal sollevamento isostatico della crosta terrestre dopo l’ultima glaciazione, che ridusse progressivamente il pescaggio disponibile. Tuttavia, alcuni indizi suggeriscono anche un mutamento delle rotte commerciali: il contemporaneo sviluppo di Hedeby, nello Jutland, e di Birka, sul lago Mälaren, avrebbe dirottato i traffici verso il Baltico centrale, mentre l’ascesa del regno norvegese unificato sotto Harald Bellachioma spostava il baricentro politico verso Trondheim. Kaupang non venne distrutta, ma semplicemente abbandonata, e la sua memoria sopravvisse nelle saghe come un luogo leggendario di ricchezza e scambi. Oggi il sito è patrimonio culturale norvegese e continua a restituire reperti che costringono a ripensare l’immagine del vichingo come semplice predone, restituendo invece il profilo di un sofisticato uomo d’affari capace di integrare economie lontane migliaia di chilometri. Le ricerche archeologiche a Kaupang hanno radicalmente modificato la percezione della civiltà norrena: più che un avamposto di razziatori, l’emporio fu una macchina economica dove argento, ambra, schiavi e tecnologia artigianale si intrecciavano in un sistema che anticipò per molti aspetti il capitalismo mercantile del Basso Medioevo.
Pagine:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 110 111 112 113 114 115 116 117 118 119 120 121 122 123 124 125 126 127 128 129 130 131 132 133 134 135 136 137 138 139 140 141 142 143 144 145 146 147 148 149 150 151 152 153 154 155 156 157 158 159 160 161 162 163 164 165 166 167 168 169 170 171 172 173 174 175 176 177 178 179 180 181 182 183 184 185 186 187 188 189 190 191 192 193 194 195 196 197 198 199 200 201 202 203 204 205 206 207 208 209 210 211 212 213 214 215 216 217 218 219 220 221 222 223 224 225 226 227 228 229 230 231 232 233 234 235 236 237 238 239 240 241 242 243 244 245 246 247 248 249 250 251 252 253 254 255 256 257 258 259 260 261 262 263 264 265 266 267 268 269 270 271 272 273 274 275 276 277 278 279 280 281 282 283 284 285 286 287 288 289 290 291 292 293 294 295 296 297 298 299 300 301 302 303 304 305 306 307 308 309 310 311 312 313 314 315 316 317 318 319 320 321 322 323 324 325 326 327 328 329 330 331 332 333 334 335 336 337 338 339 340 341 342 343 344 345 346 347 348 349 350 351 352 353 354 355 356 357 358 359 360 361 362 363 364 365 366 367 368 369 370 371 372 373 374 375 376 377 378 379 380 381 382 383 384 385 386 387 388 389 390 391 392 393 394 395 396 397 398 399 400 401 402 403 404 405 406 407 408 409 410 411 412 413 414 415 416 417 418 419 420 421 422 423 424 425 426 427 428 429 430 431 432 433 434 435 436 437 438 439 440 441 442 443 444 445 446 447 448 449 450 451 452 453 454 455 456 457 458 459 460 461 462 463 464 465 466 467 468 469 470 471 472 473 474 475 476 477 478 479 480 481 482 483 484 485 486 487 488 489 490 491 492 493 494 495 496 497 498 499 500 501 502 503 504 505 506 507 508 509 510 511 512 513 514 515 516 517 518 519 520 521 522 523 524 525 526 527 528 529 530 531 532 533 534 535 536 537 538 539 540 541 542 543 544 545 546 547 548 549 550 551 552 553 554 555 556 557 558 559