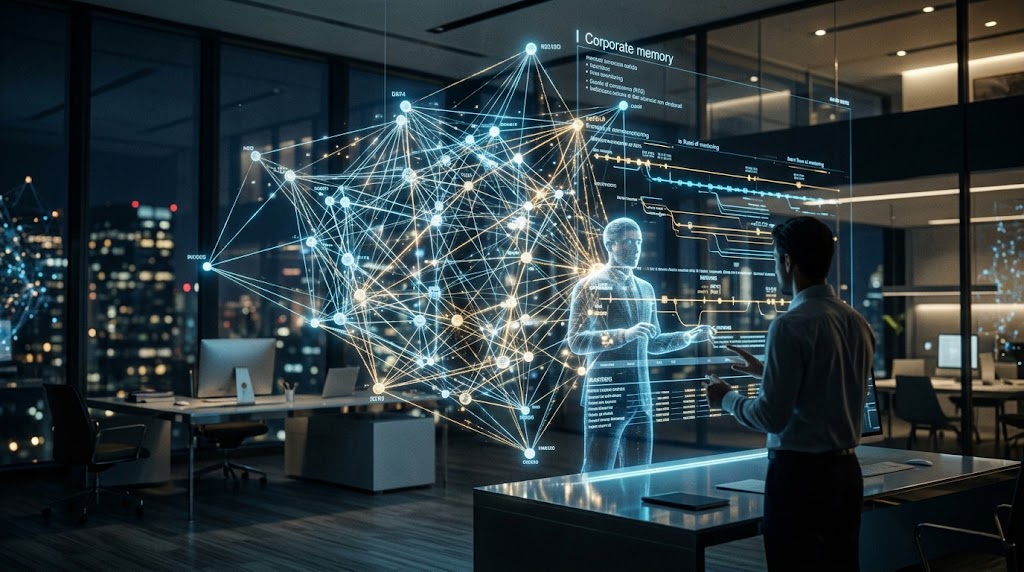
Rappresentazione tridimensionale di un grafo di conoscenza neurale che connette flussi di dati aziendali non strutturati
Nel decennio 2027-2036, la sopravvivenza competitiva delle imprese dipenderà dalla capacità di catturare la conoscenza tacita dispersa in riunioni, chat, codice e schemi tecnici. L'evoluzione delle architetture Graph RAG trasformerà questo oceano di dati non strutturati in una Corporate Memory viva, capace di offrire mentoring sintetico perpetuo. LEGGI TUTTO L'ARTICOLO.
🎧 Ascolta questo articolo
Bonus Video
L'emorragia del sapere tacito e l'ingestione multimodale dell'ecosistema non strutturato
Nelle grandi organizzazioni industriali, finanziarie e tecnologiche, oltre l'ottanta per cento del patrimonio informativo reale non risiede all'interno di database relazionali ordinati in righe e colonne SQL, bensì fluttua in un immenso arcipelago di dati non strutturati ed effimeri: registrazioni audio e video di riunioni tecniche, lunghe catene di messaggi su piattaforme di collaborazione istantanea, annotazioni a margine su disegni CAD, commit di codice sorgente, ticket di manutenzione risolti d'urgenza in fabbrica e scambi di posta elettronica. Quando un ingegnere capo o uno specialista di processo va in pensione o cambia azienda, questa conoscenza tacita — fatta non solo di procedure ufficiali, ma soprattutto della memoria storica dei tentativi falliti, delle eccezioni operative e del perchè una determinata scelta progettuale fu scartata cinque anni prima — svanisce istantaneamente, provocando quella che gli analisti definiscono amnesia organizzativa cronica. Nel decennio compreso tra il 2027 e il 2036, la tecnologia della Corporate Memory risolve strutturalmente questa emorragia cognitiva implementando pipeline di ingestione multimodale continua a latenza zero. Modelli di intelligenza artificiale percettiva analizzano in tempo reale ogni artefatto digitale prodotto dall'azienda: i flussi vocali vengono trascritti con diarizzazione del parlante e analisi prosodica per distinguere un'ipotesi dubbiosa da una decisione esecutiva; i diagrammi ingegneristici e le lavagne digitali vengono scomposti da reti di visione artificiale in entità logiche; i repository software vengono mappati insieme alle discussioni architetturali che li hanno generati, sottoponendo ogni frammento a filtri crittografici automatici che oscurano i dati personali sensibili e applicano etichette di controllo degli accessi basate sui ruoli (RBAC) direttamente a livello di singolo token semantico.
Dal recupero vettoriale miope all'architettura neuro-simbolica del Graph RAG
La prima generazione di sistemi di Retrieval-Augmented Generation (RAG), affermatasi intorno alla metà degli anni Venti del Duemila, presentava un limite strutturale invalicabile: spezzettava i documenti aziendali in piccoli blocchi di testo (chunk) e li proiettava in uno spazio matematico multidimensionale sotto forma di vettori numerici (embeddings). Sebbene efficace per trovare paragrafi lessicalmente simili a una domanda dell'utente, la ricerca puramente vettoriale soffre di miopia contestuale: è incapace di collegare informazioni distanti nel tempo, non comprende i nessi di causa-effetto distribuiti su centinaia di file diversi e fallisce miseramente quando deve rispondere a interrogazioni globali o multi-hop, come ricostruire l'intera catena di dipendenze tra un ritardo di fornitura di un semiconduttore nel 2026, una modifica al firmware approvata in una chat di reparto tre mesi dopo e un'anomalia termica riscontrata sul campo nel 2028. L'architettura Graph RAG (Graph-based Retrieval-Augmented Generation) supera questo ostacolo fondendo la flessibilità statistica dei Large Language Models con il rigore deterministico dei grafi di conoscenza (Knowledge Graphs). Durante la fase di indicizzazione, agenti estrattori specializzati scandagliano il flusso non strutturato per identificare nodi ontologici — progetti, componenti hardware, clienti, normative, persone, incidenti — e archi direzionali pesati che ne definiscono le relazioni semantiche e temporali (ha causato, sostituisce, dipende da, è stato approvato da). Applicando algoritmi di rilevamento delle comunità su grafo, come l'algoritmo di Leiden gerarchico, il sistema raggruppa automaticamente milioni di nodi in cluster tematici multilivello e pre-genera sintesi astratte per ciascuna comunità: quando un sistema viene interrogato, il motore ibrido esegue simultaneamente una ricerca vettoriale locale e una traversata topologica sul grafo, risalendo i legami causali e temporali per fornire al modello generativo un contesto privo di allucinazioni e interamente verificabile fino alla fonte primaria.
Paradigma Architetturale
Meccanismo di Indicizzazione e Recupero
Capacità di Ragionamento Aziendale
RAG Vettoriale Tradizionale (Baseline)
Frammentazione in chunk testuali e similarità del coseno
Recupero puntuale di singoli passaggi ma cecità sulle relazioni globali e temporali
Graph RAG Temporale (2027-2031)
Estrazione di entità, relazioni causali e clustering di Leiden
Ragionamento multi-hop su eventi complessi e tracciabilità delle decisioni storiche
Mentoring Sintetico Cognitivo (2032-2036)
Gemelli decisionali su grafo dinamico con memoria episodica
Affiancamento proattivo, trasferimento del know-how tacito e simulazione di scenari
Grafi temporali dinamici e l'era del mentoring sintetico personalizzato
L'innesto di una dimensione cronologica nativa trasforma il grafo di conoscenza in un Temporal Knowledge Graph, capace di gestire il decadimento dell'informazione e la risoluzione automatica delle contraddizioni: se una specifica di sicurezza del 2029 viene rettificata da un bollettino tecnico nel 2031, il grafo non cancella il nodo storico, ma aggiorna la validità temporale dell'arco relazionale, permettendo all'intelligenza artificiale di conoscere sia la regola vigente oggi sia le ragioni storiche che hanno portato al superamento della precedente. Su questa infrastruttura neuro-simbolica fiorisce, nella prima metà degli anni Trenta, il paradigma del mentoring sintetico. Invece di costringere i nuovi assunti o i ricercatori a consultare passivamente manuali statici o a formulare query di ricerca, la Corporate Memory alimenta agenti mentori autonomi integrati negli ambienti di lavoro operativi. Quando un giovane ingegnere sta progettando una valvola idraulica o scrivendo un modulo software, il mentore sintetico osserva il contesto operativo in tempo reale, naviga silenziosamente il grafo aziendale e interviene con la voce e l'esperienza stratificata dell'intera organizzazione, segnalando ad esempio che una geometria analoga era già stata testata dal team di Monaco quattro anni prima ed era stata abbandonata per fenomeni di cavitazione ad alte pressioni, mostrando istantaneamente il video del test di laboratorio originale e i calcoli strutturali dell'epoca. L'addestramento professionale cessa così di essere un collo di bottiglia legato alla disponibilità fisica dei colleghi senior per diventare un dialogo socratico continuo con l'intelligenza collettiva dell'impresa, riducendo da anni a poche settimane il tempo necessario per portare un professionista alla piena padronanza dei sistemi complessi.
L'avvento della Corporate Memory basata su Graph RAG e mentoring sintetico segna il passaggio storico dall'informatica dell'archiviazione all'informatica della coscienza organizzativa: nel decennio 2027-2036 le aziende non saranno più semplici contenitori di documenti inerti destinati all'obsolescenza, ma organismi cognitivi capaci di ricordare ogni propria esperienza, apprendere dai propri errori passati e tramandare intatta la propria maestria tecnica attraverso le generazioni.